semantic gap 为什么研究机器视觉的时候都是在研究猫呢
assignment 1
2.图像分类与线性分类器
机器学习的流程: 1. 收集数据集和标签 2. 用机器学习算法训练分类器 3. 在新图像上评价分类器
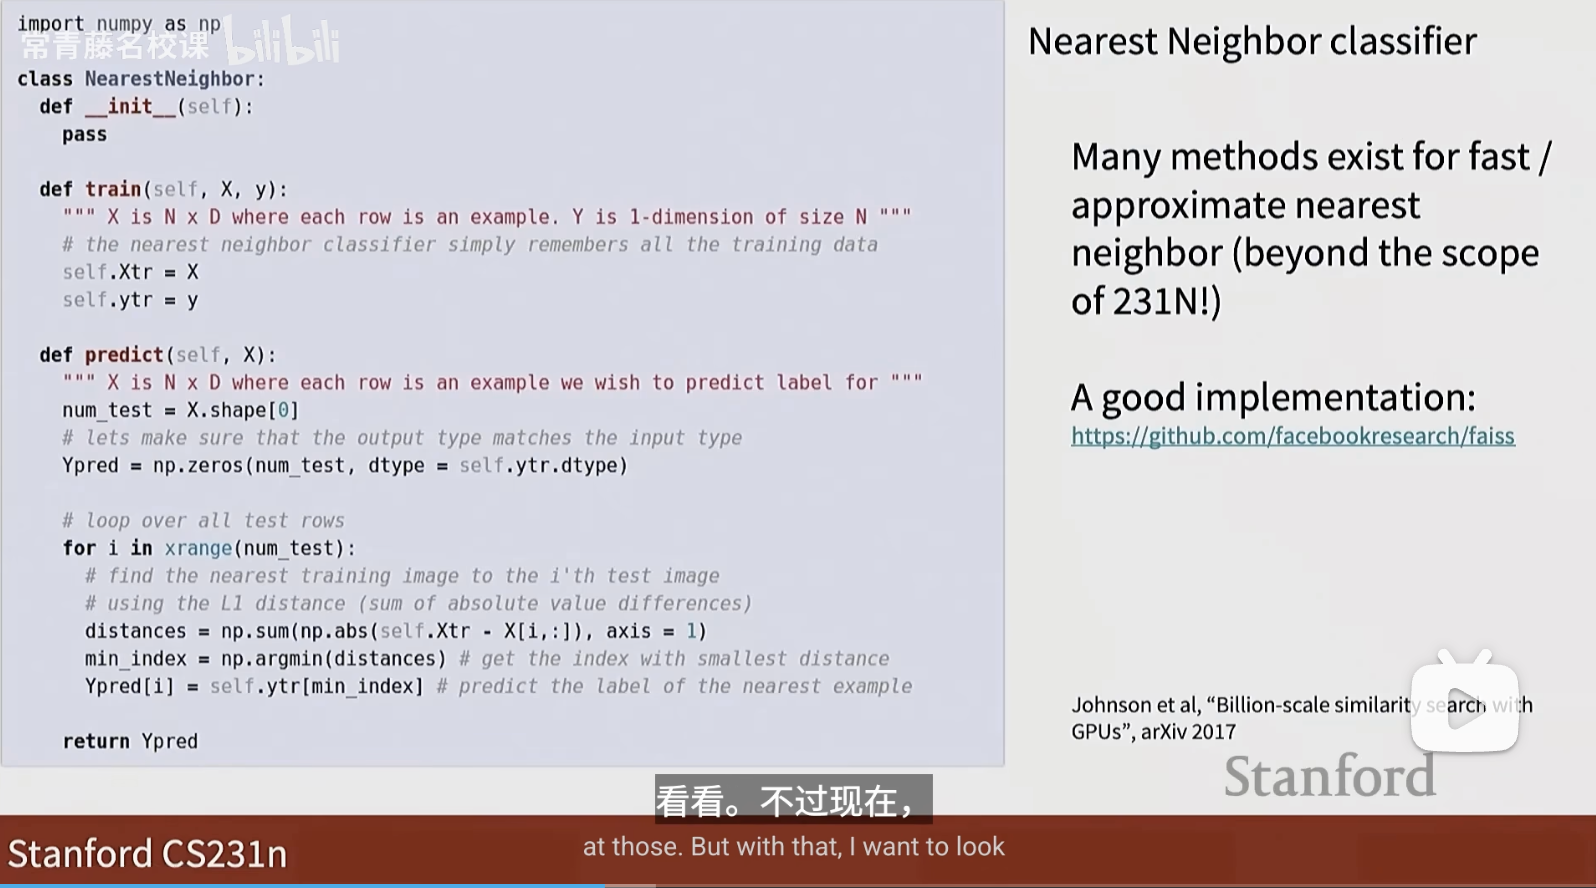
Nearest Neighbor KNN
距离函数,判断目标图像和标记图像的相似度,输出标签
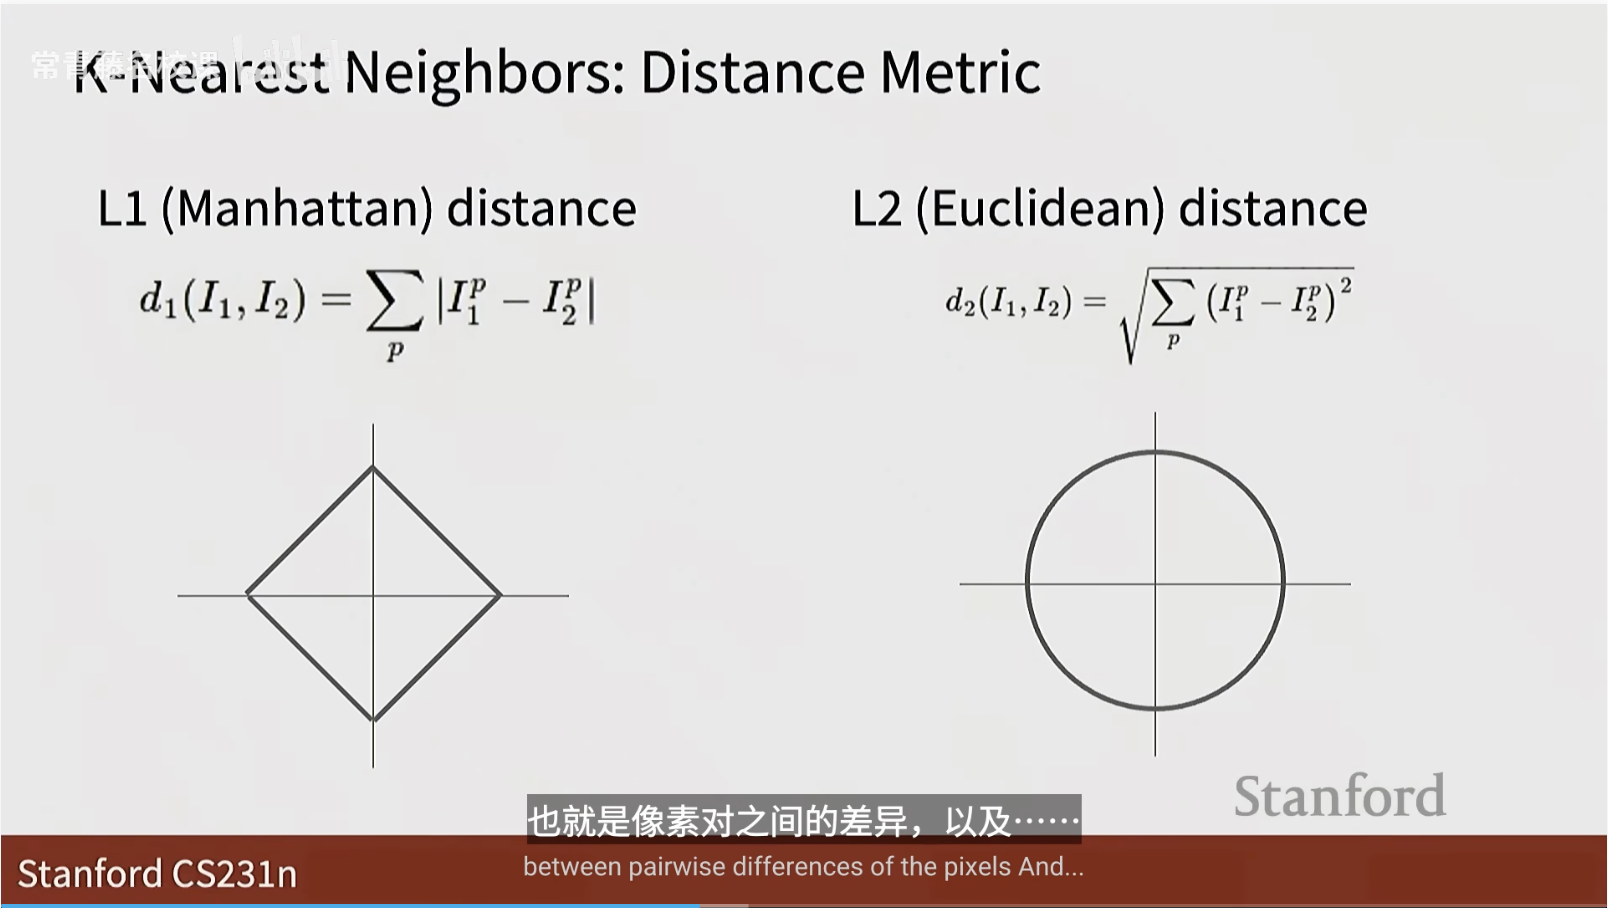
曼哈顿距离 L1 对特征值敏感,比如旋转则特征值将改变
超参数问题 hyperparameters
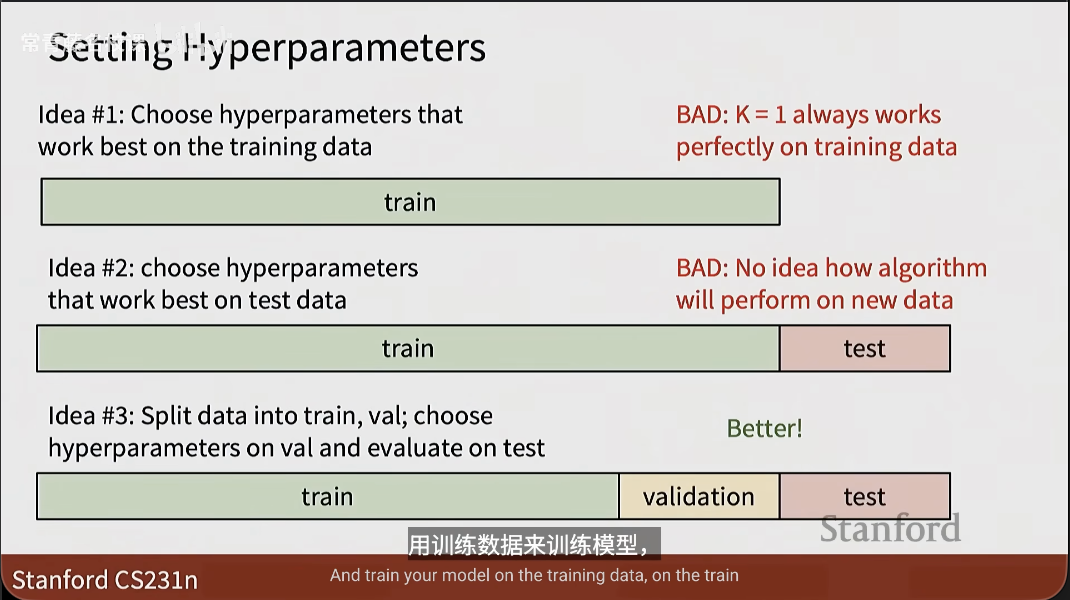
测试集、训练集、验证集
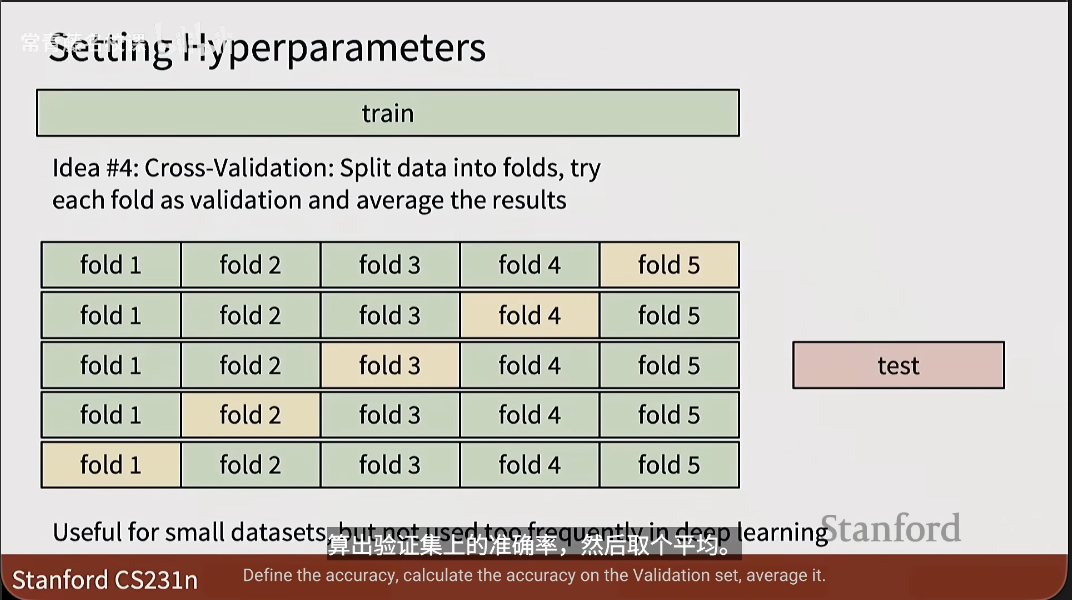
交叉验证
CIFAR10 数据集
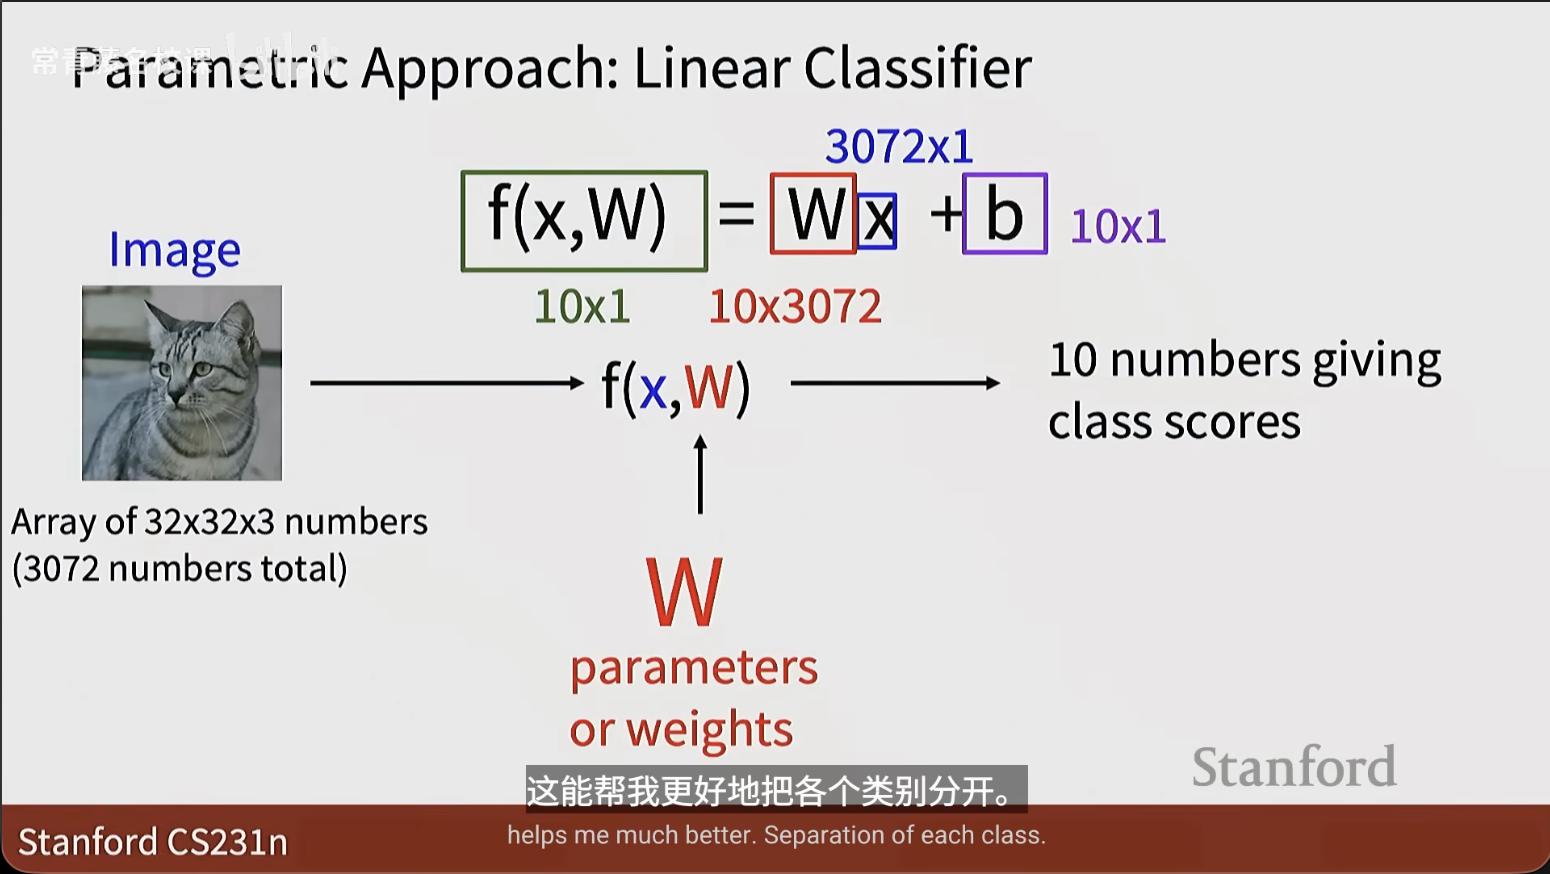
Linear Classifier
线性分类器
$$
f(x,W,b)=Wx+b
$$
权重,偏置
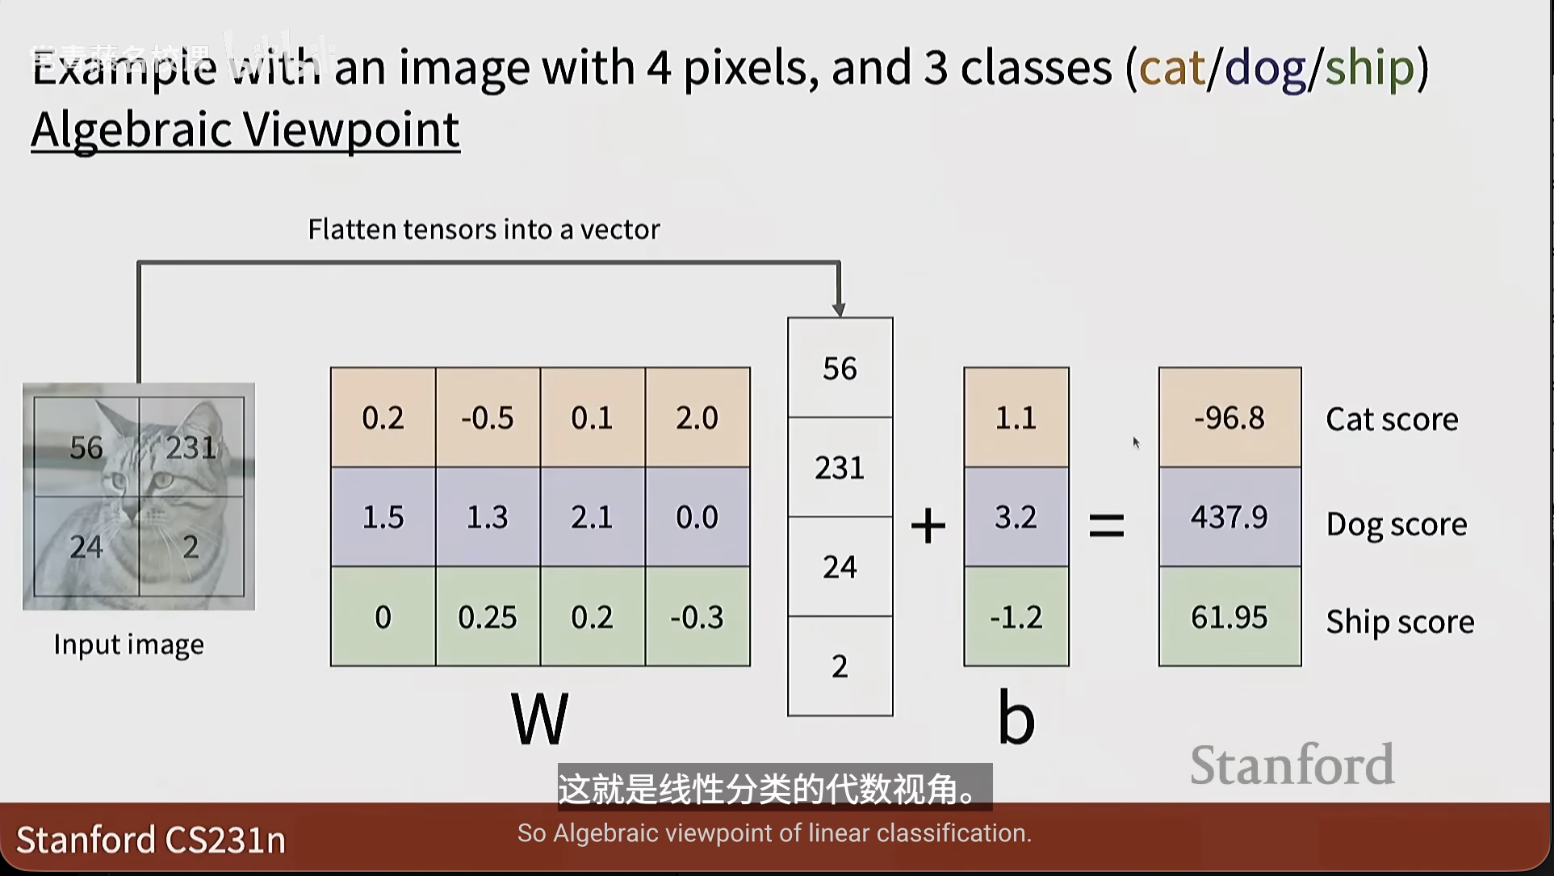
从代数视角看一个 2×2 像素图像,变成向量,输入线性函数,映射得到分数进行分类
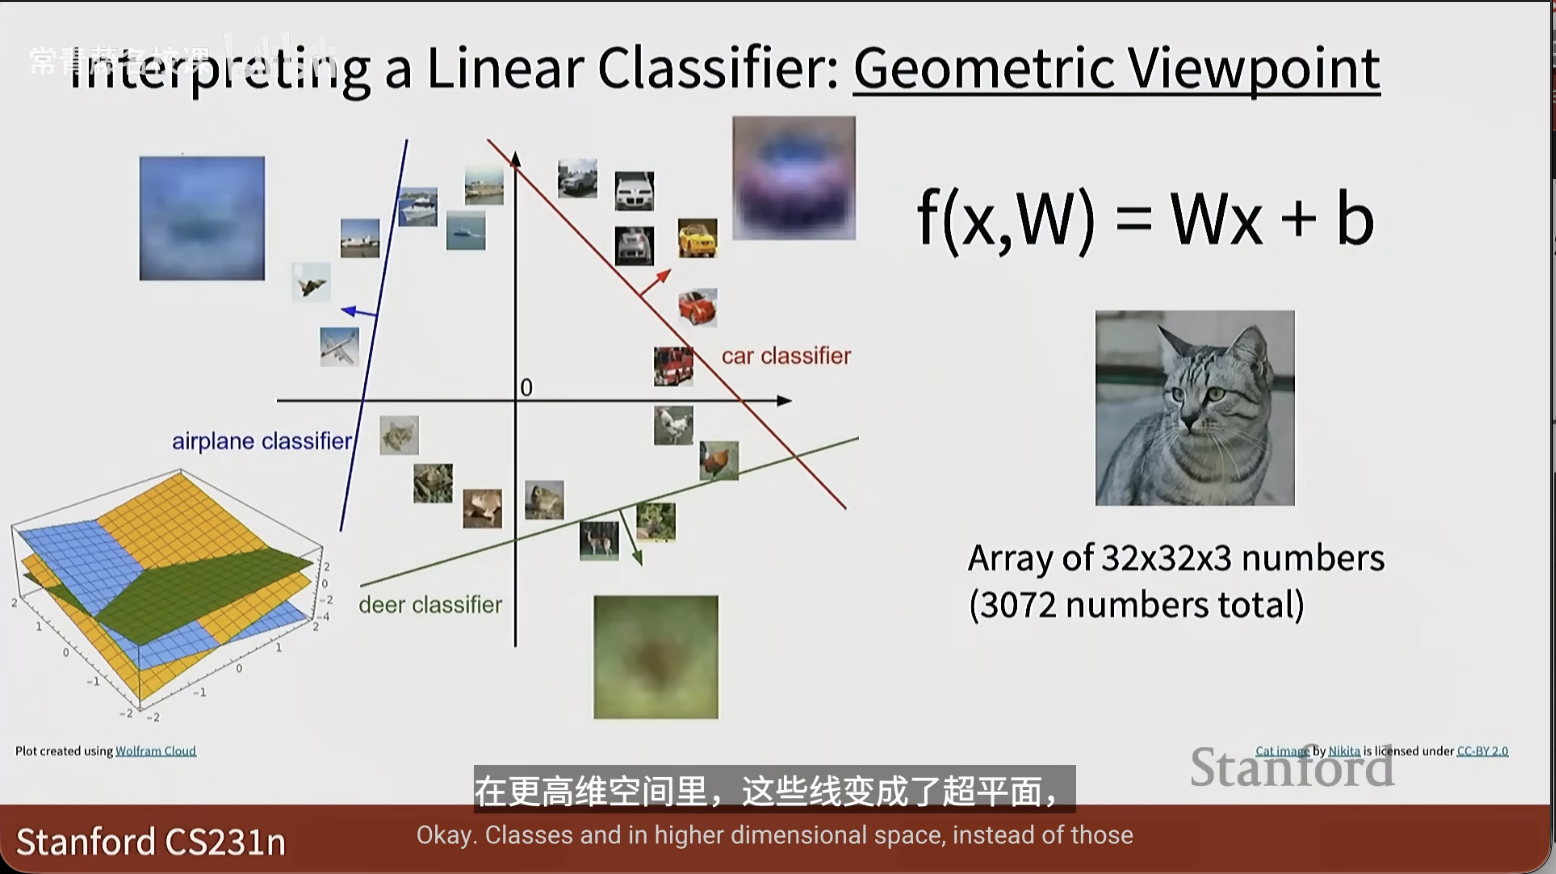
线性分类器权重:
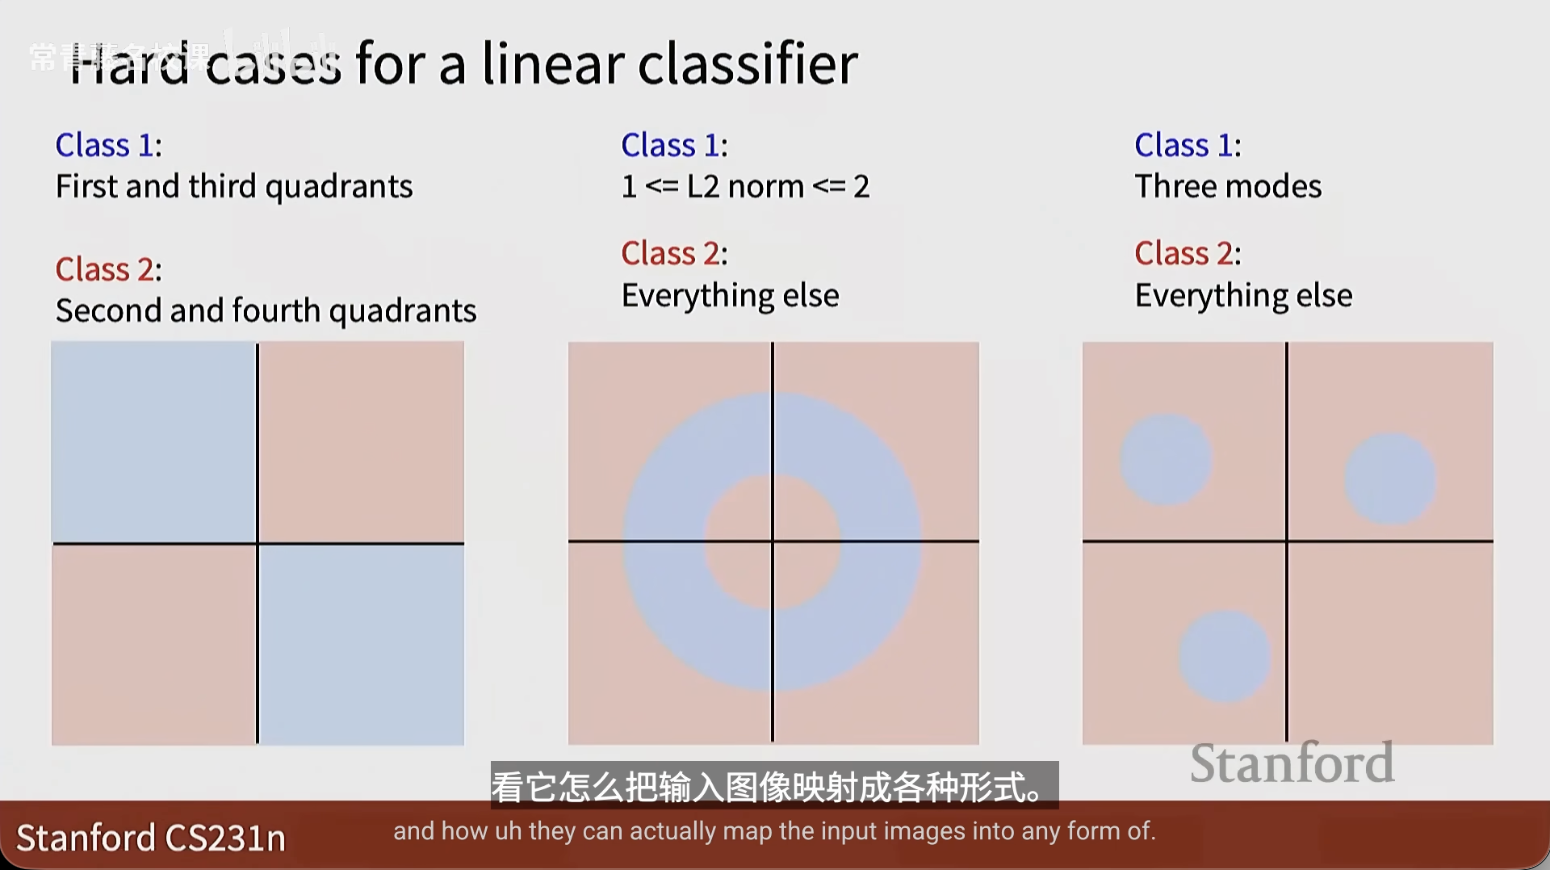
损失函数 衡量预测分数与真实分数之间的差异
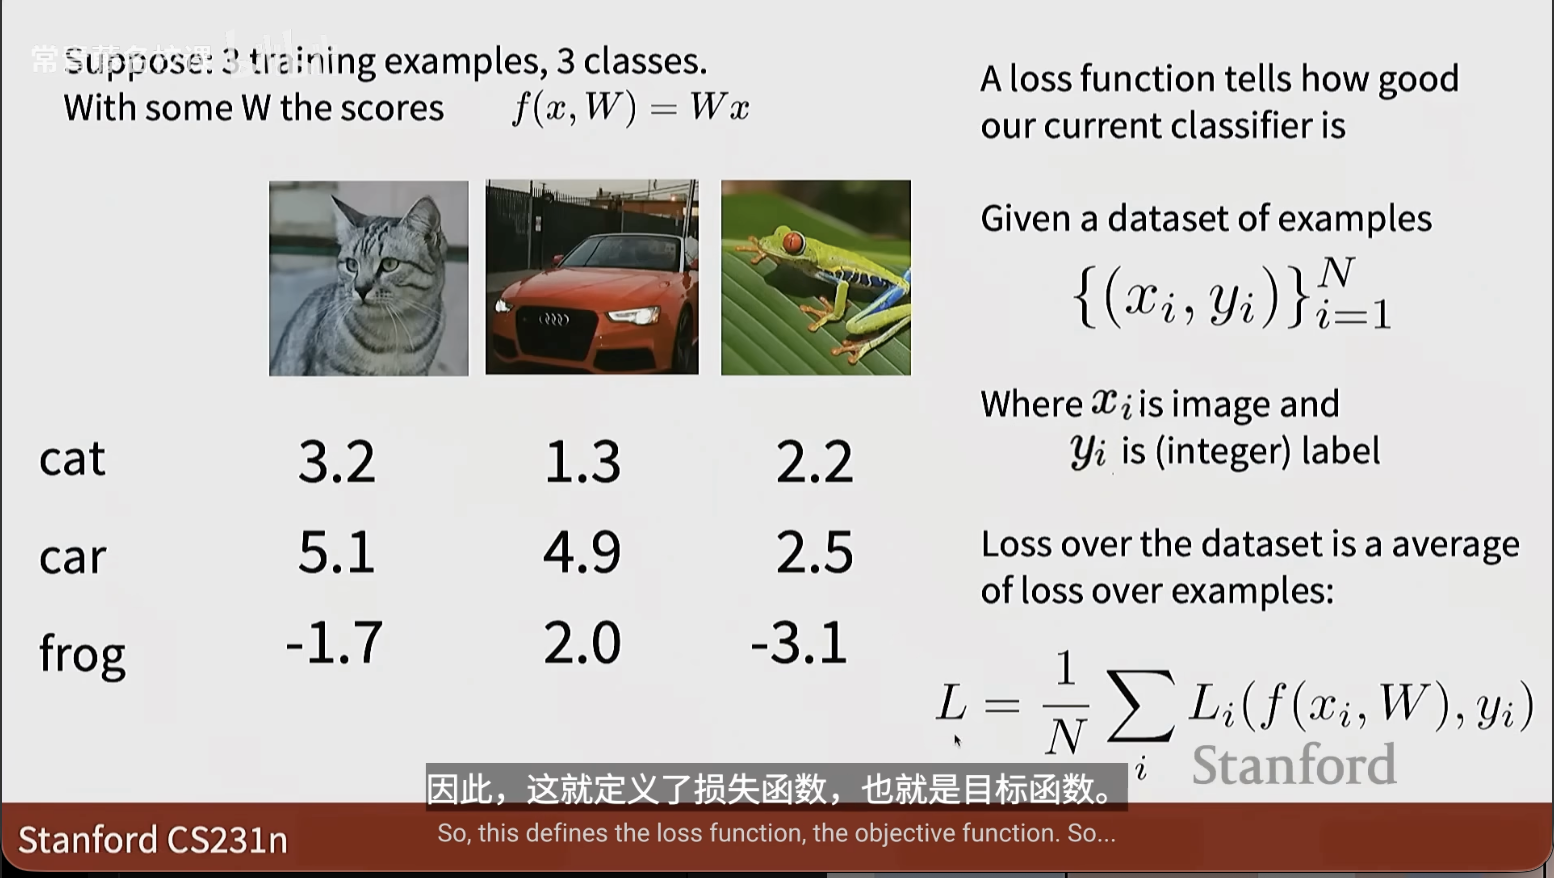
Softmax Classifier
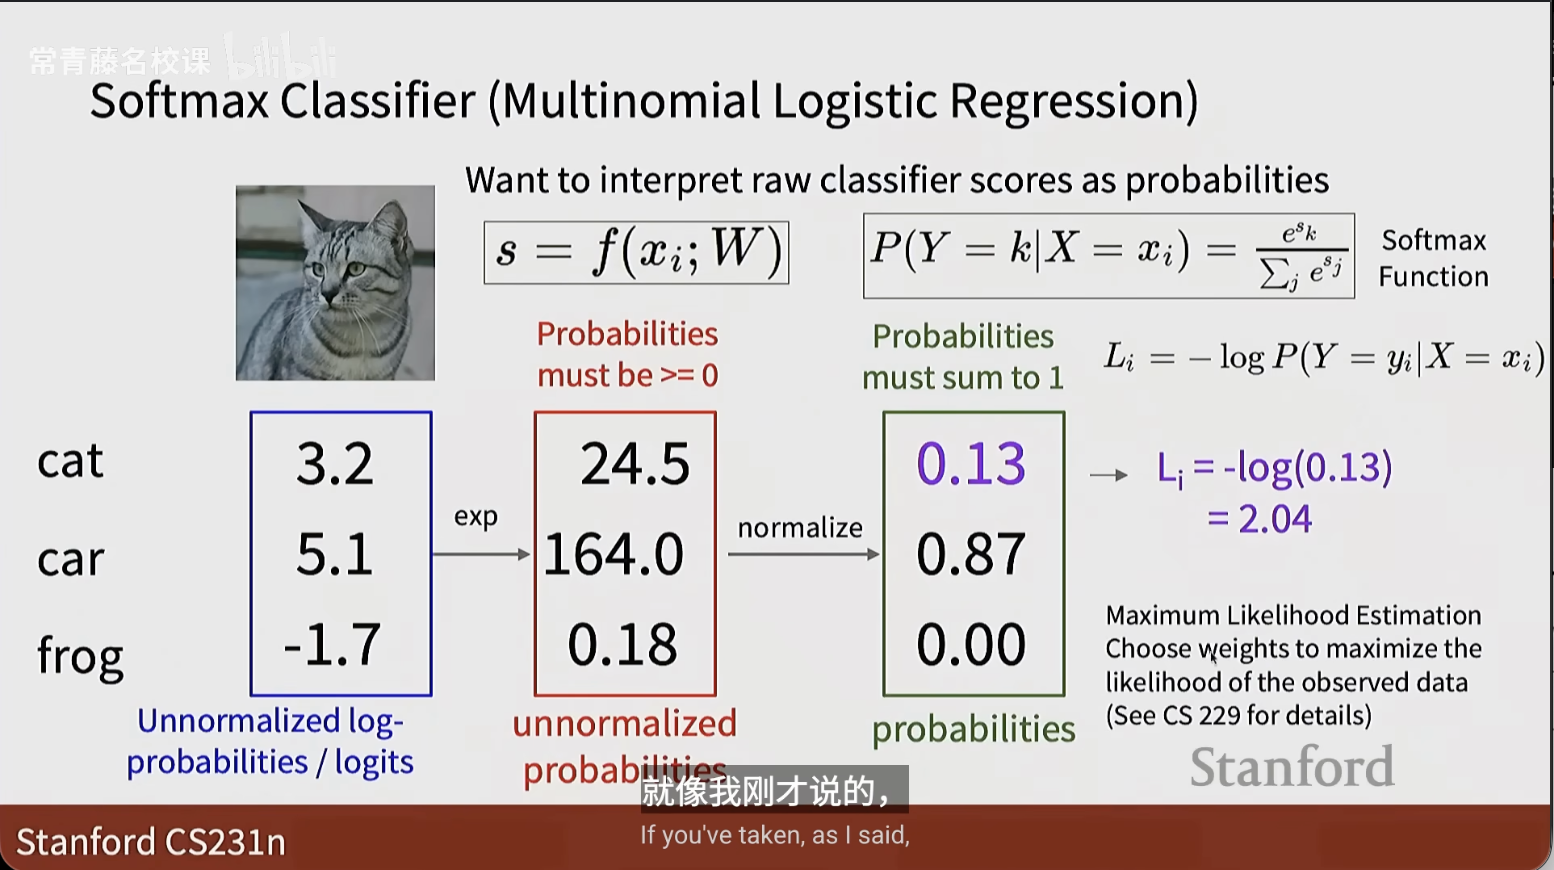
思路: 1. 把 score 转成“概率形式” 2. 用正确类别的概率计算 loss
linear classifier + softmax + loss
softmax 公式:全部分数取指数然后归一化
概率由 softmax 定义 正确类别概率取负值再取对数得到损失函数
KL 函数 交叉熵函数 BCE 二元交叉熵
3. Regularization and Optimization
正则化与优化
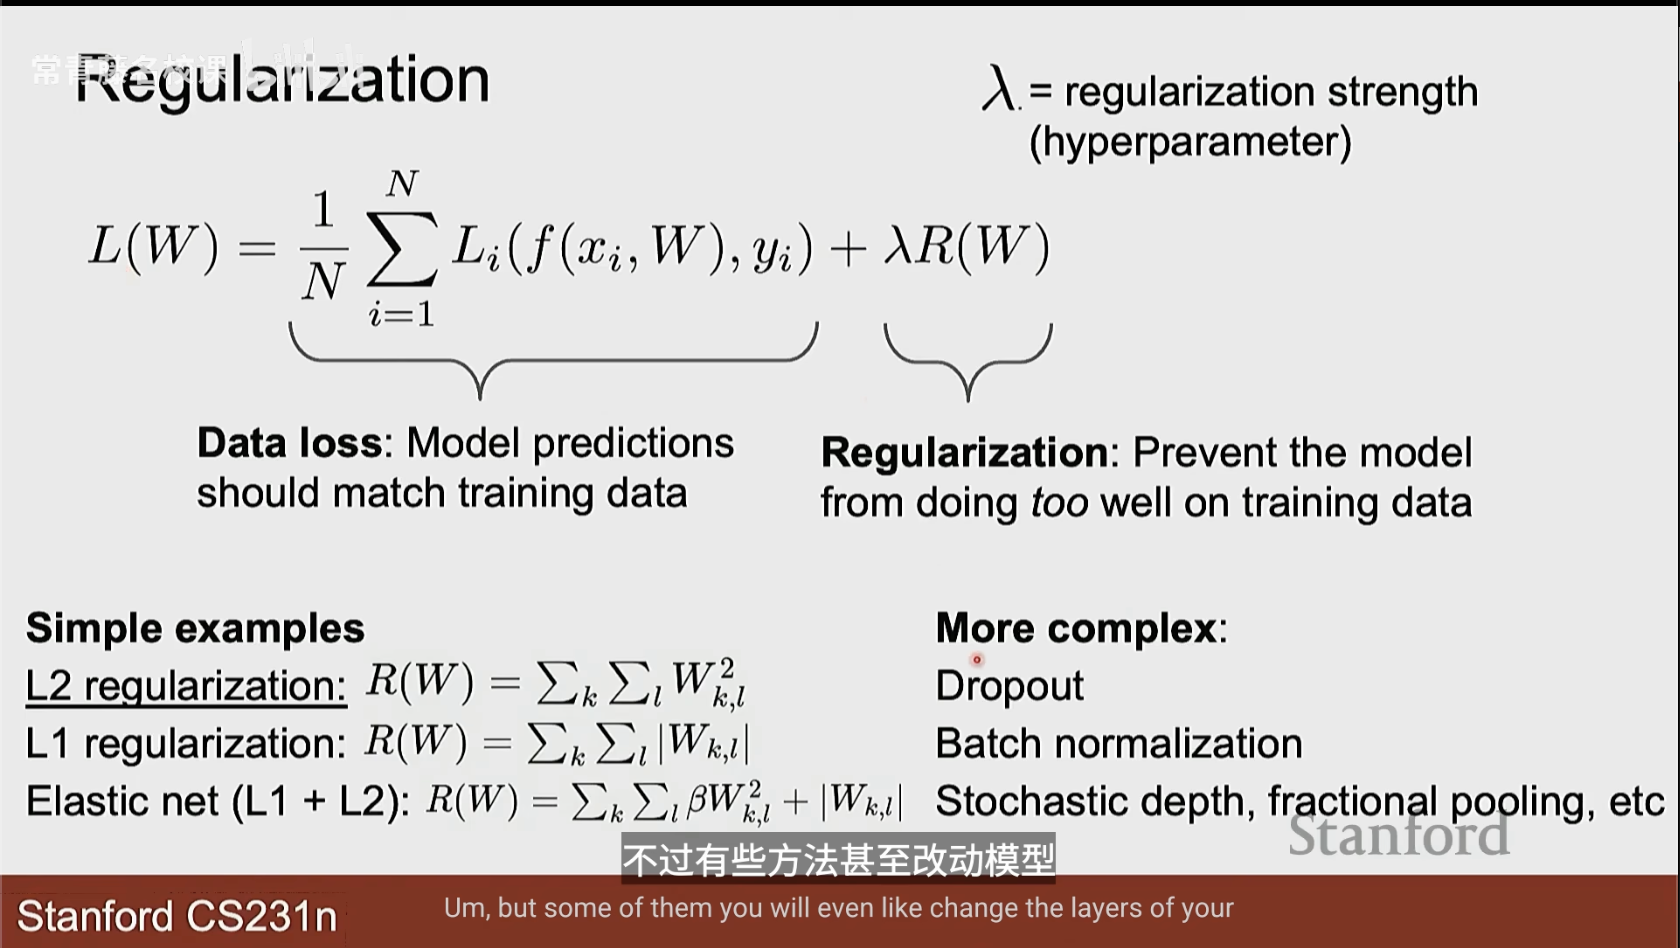
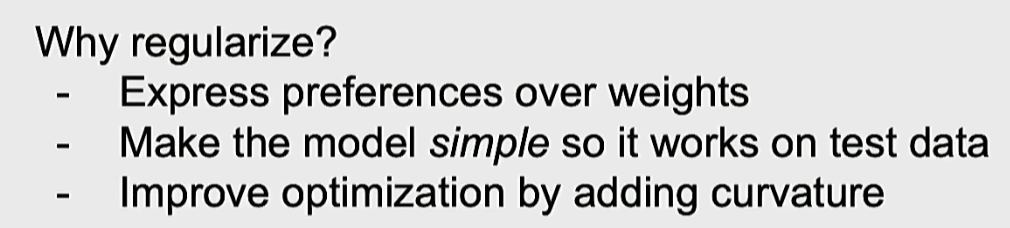
正则化目的,让训练集预测差一点但是测试集表现好一点,也就是防止过拟合
optimize
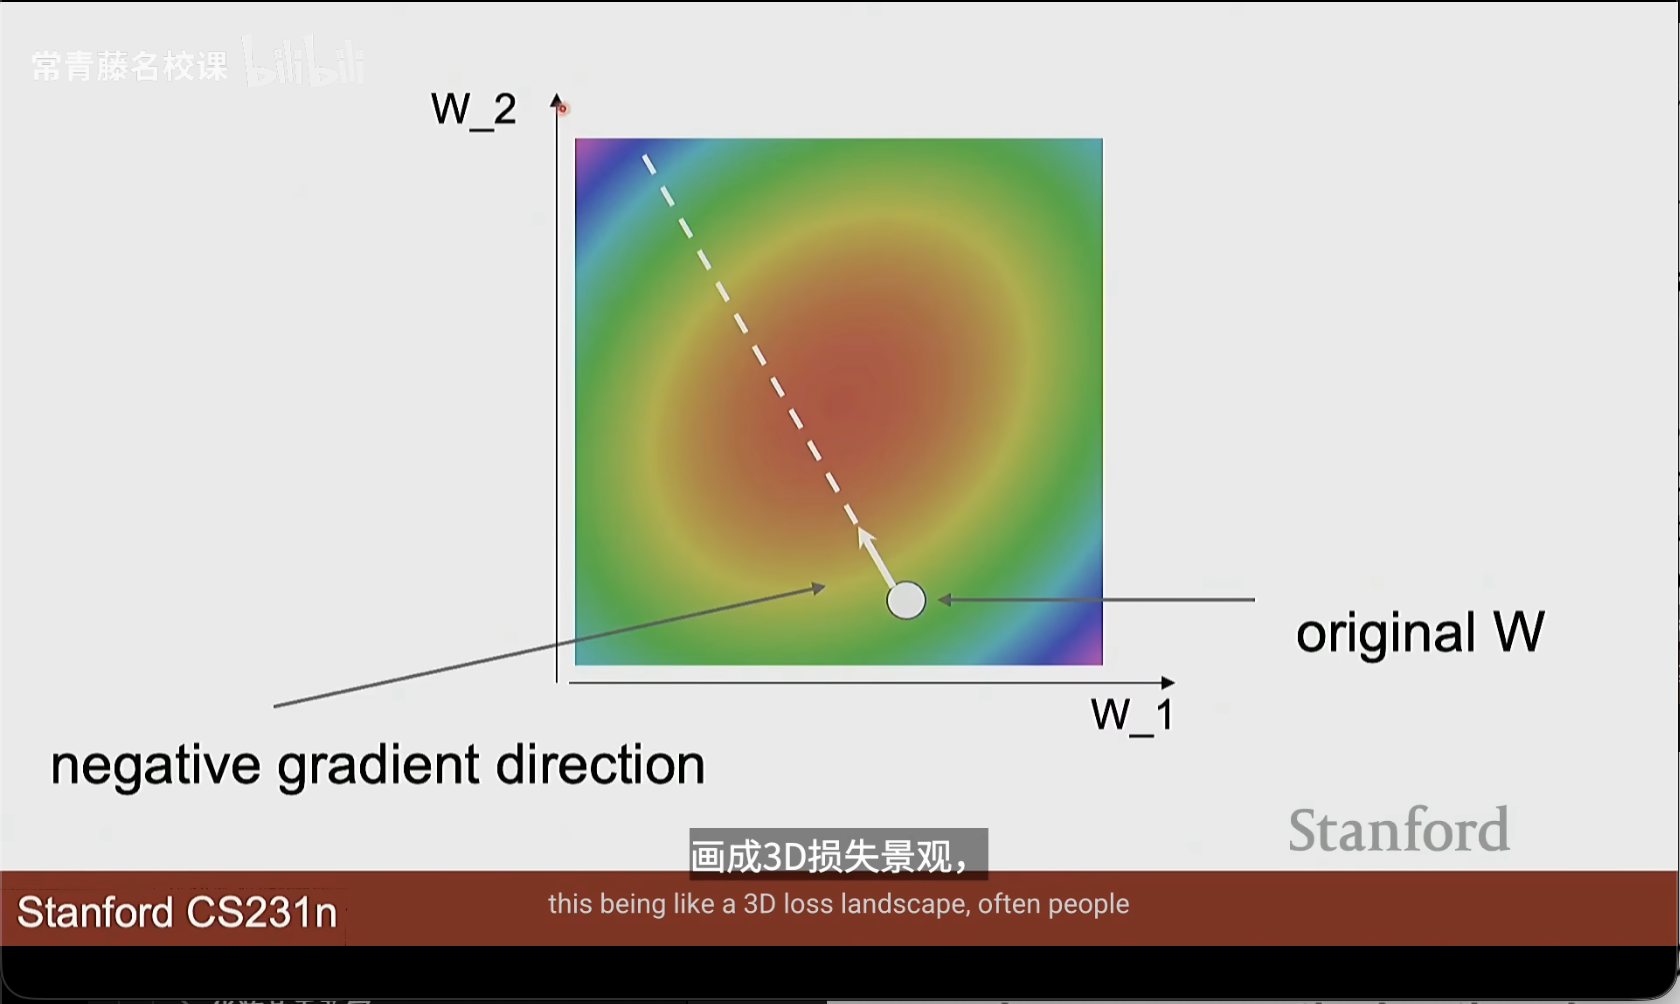
损失景观
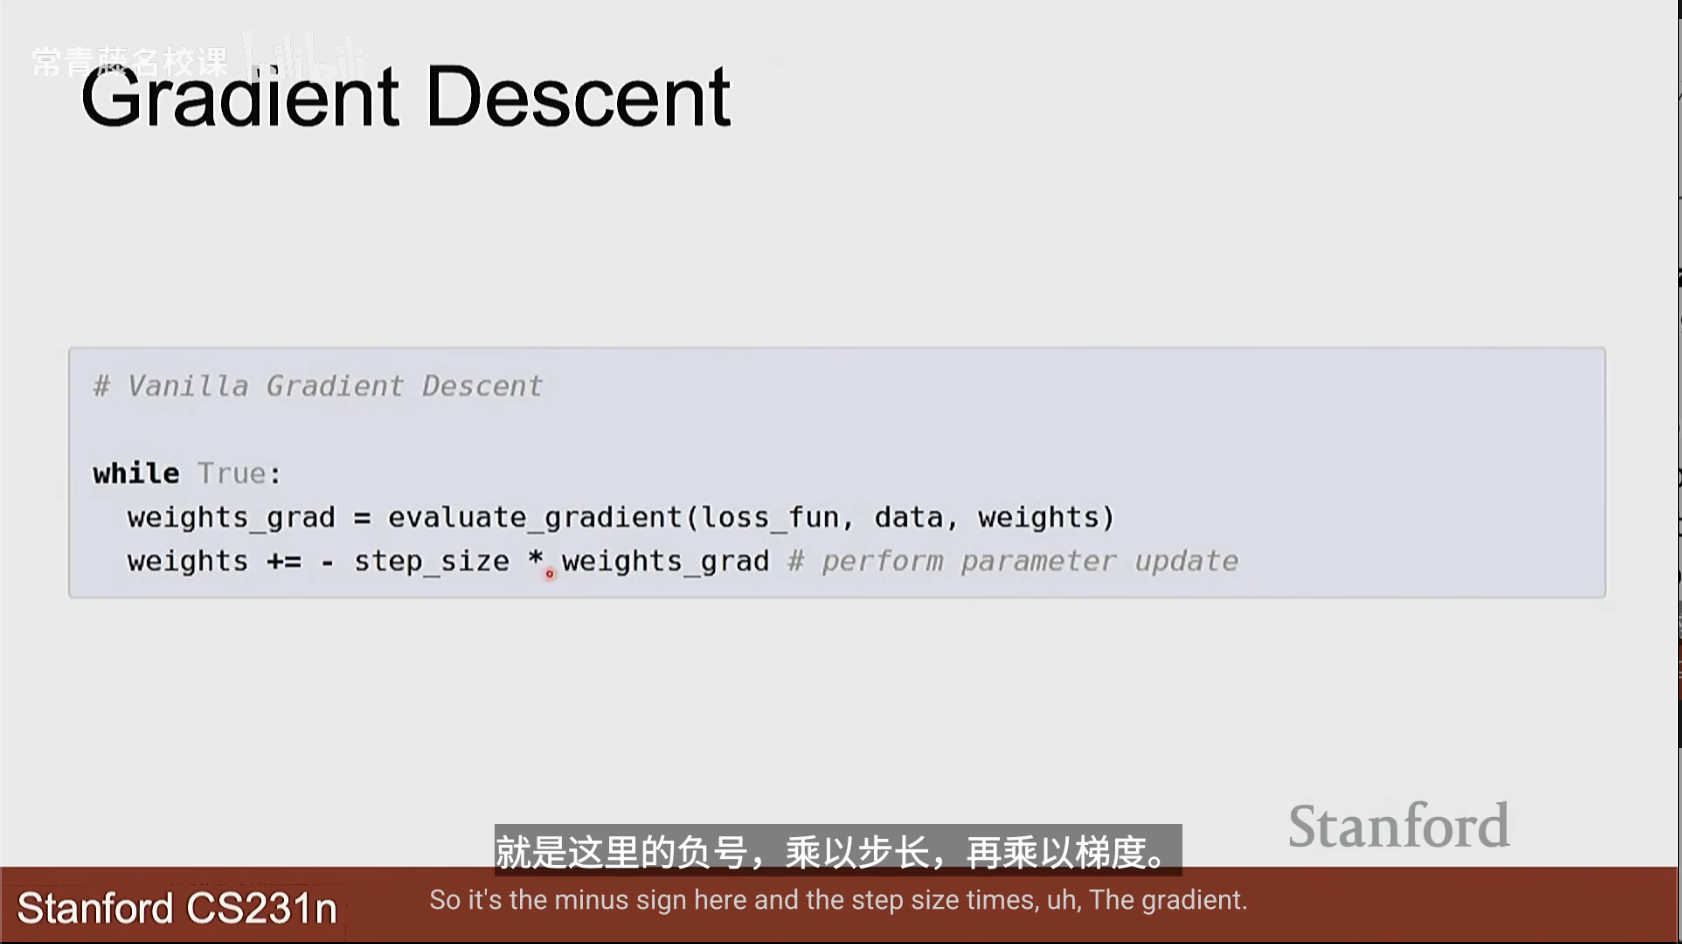
Gradient Descent梯度下降
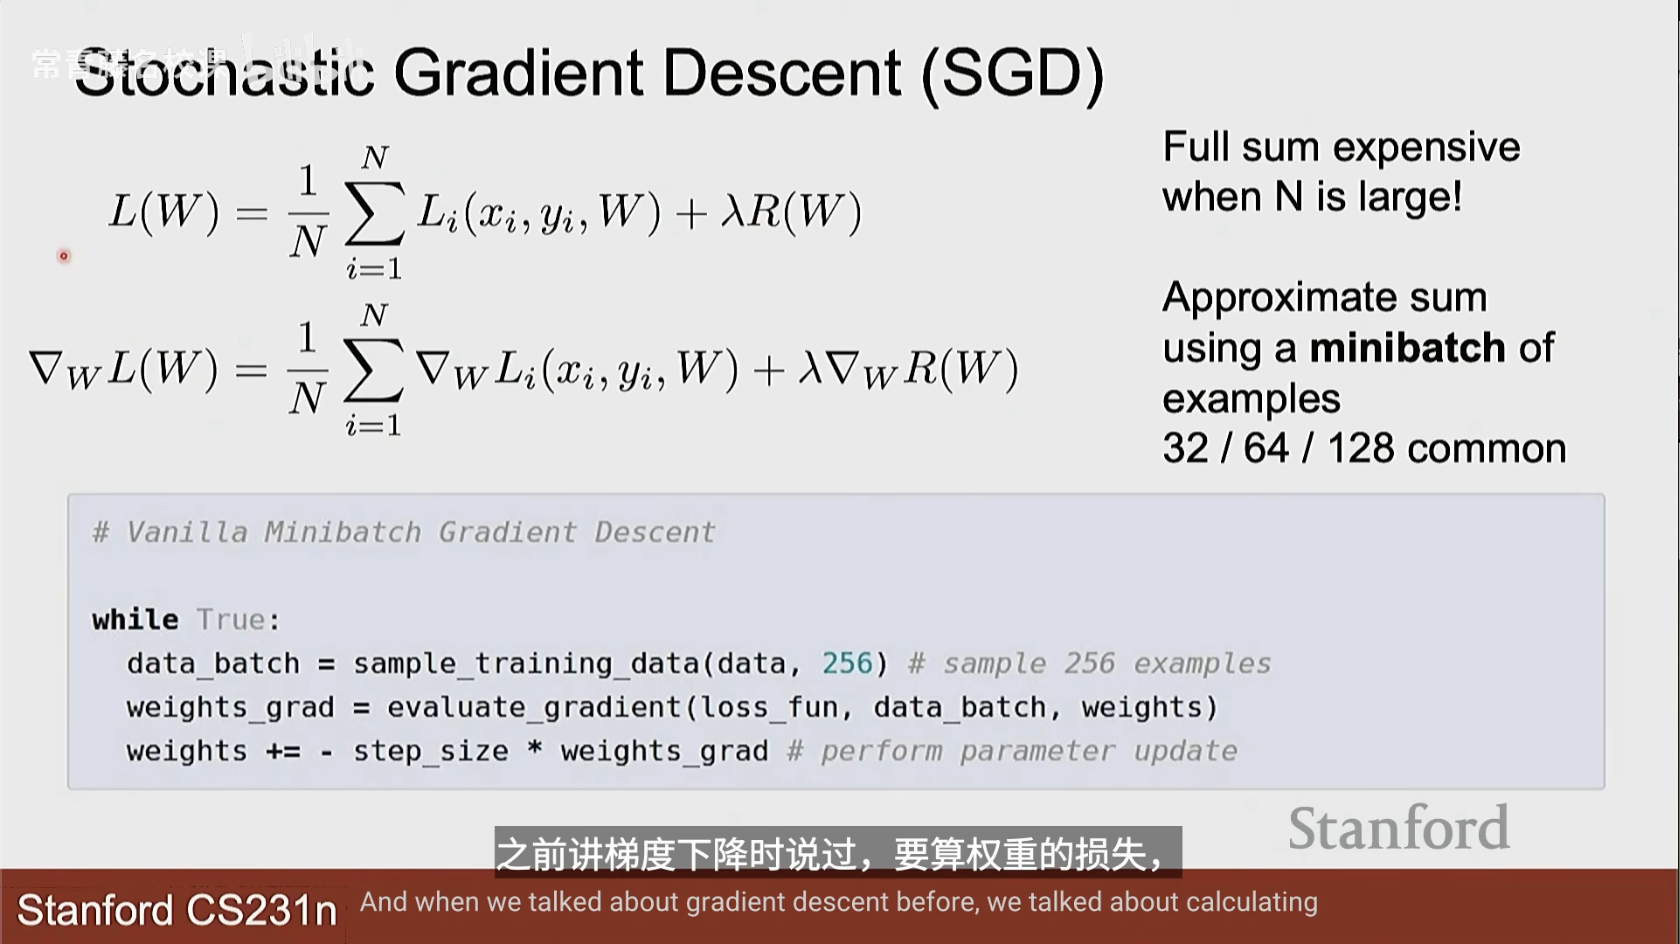
随机梯度下降
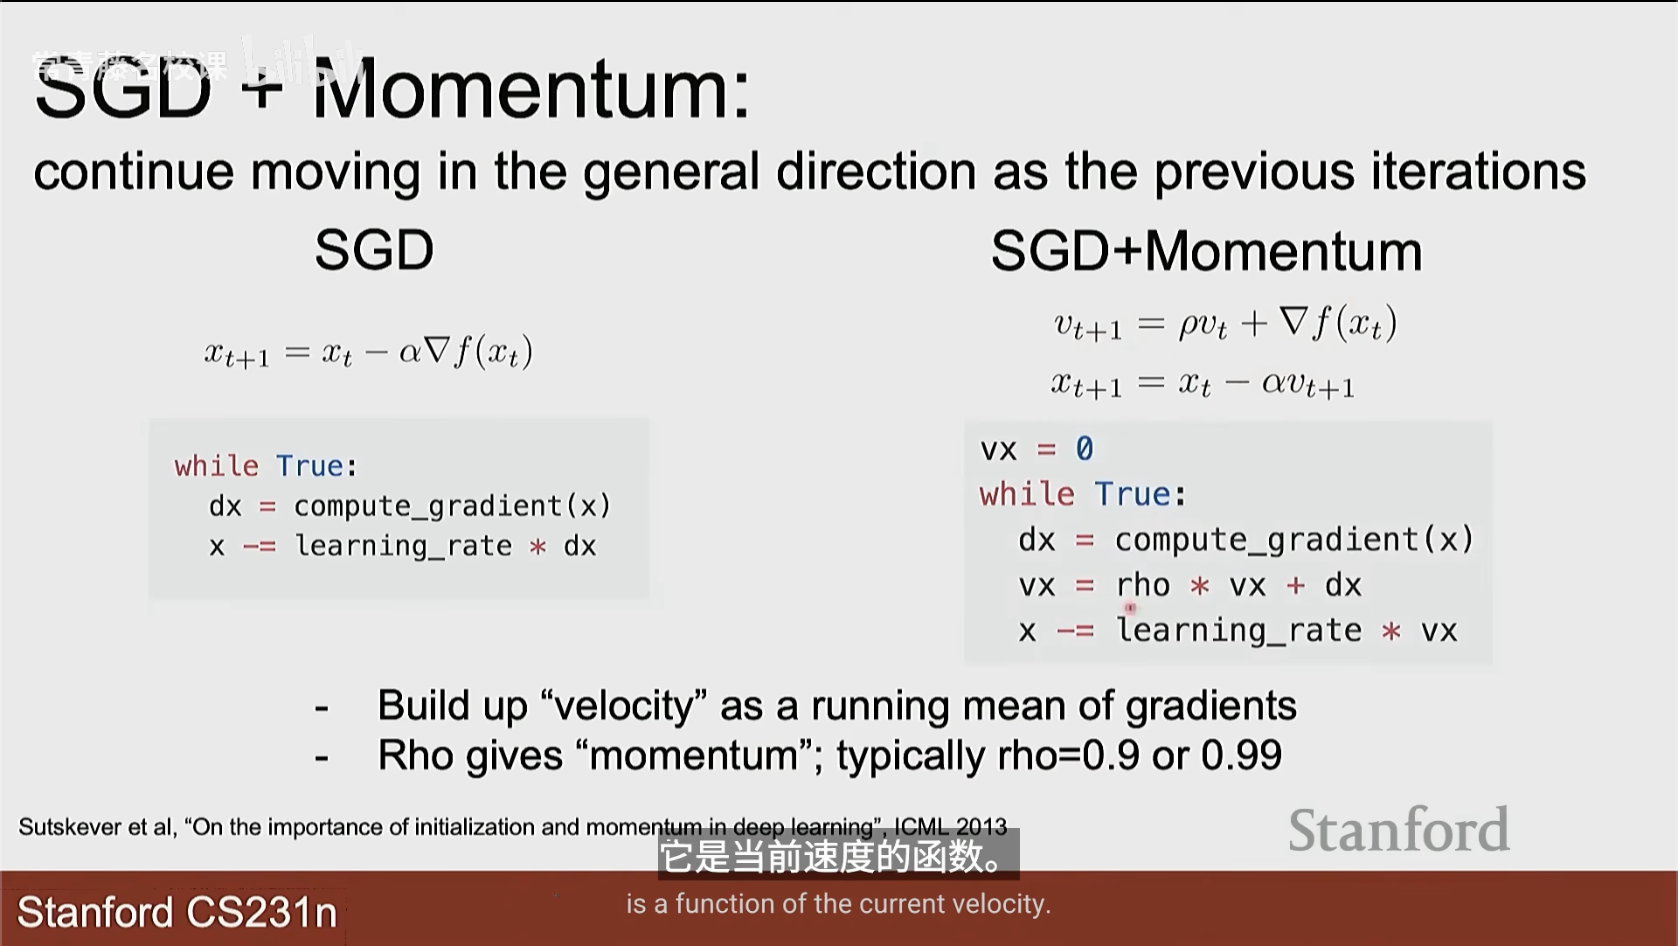
优化 SGD+动量
优化 RMSProp
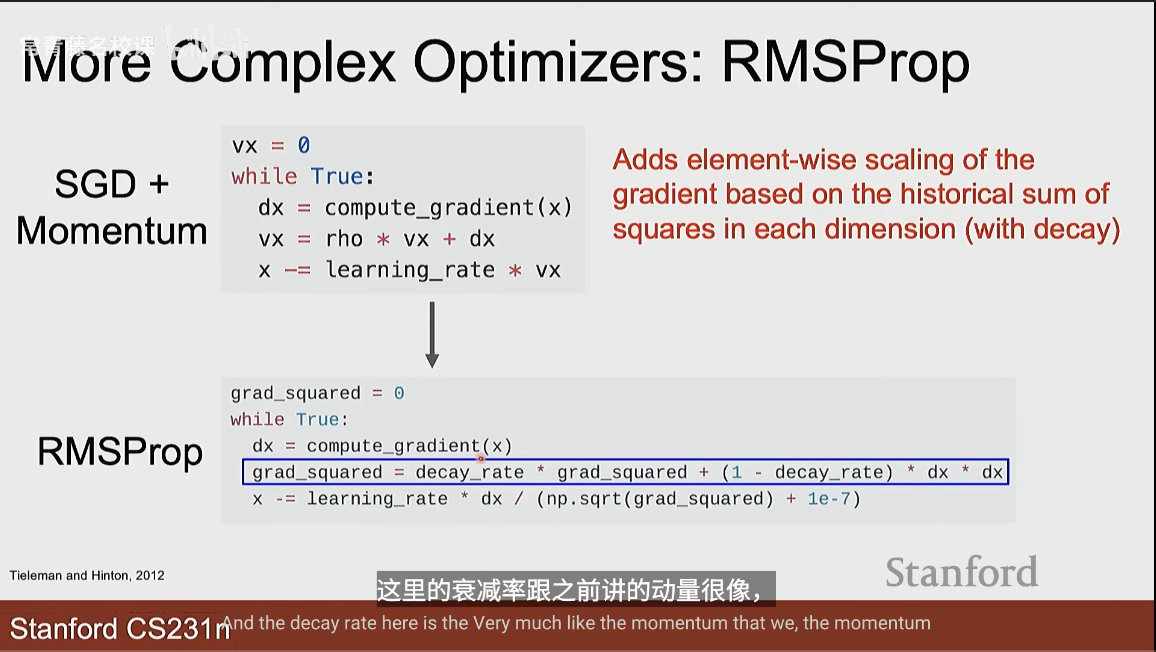
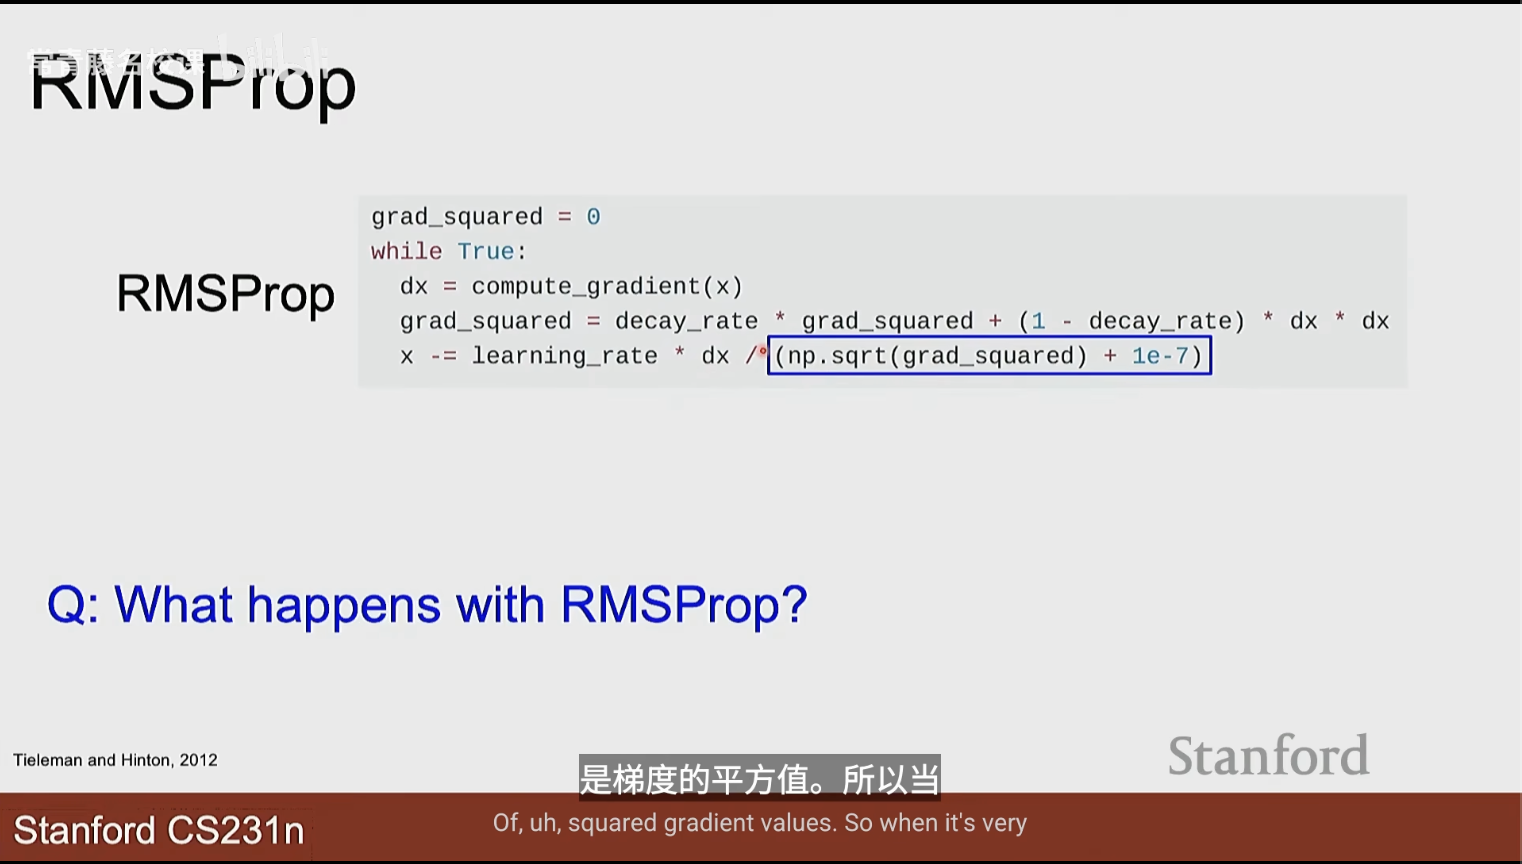
优化 Adam
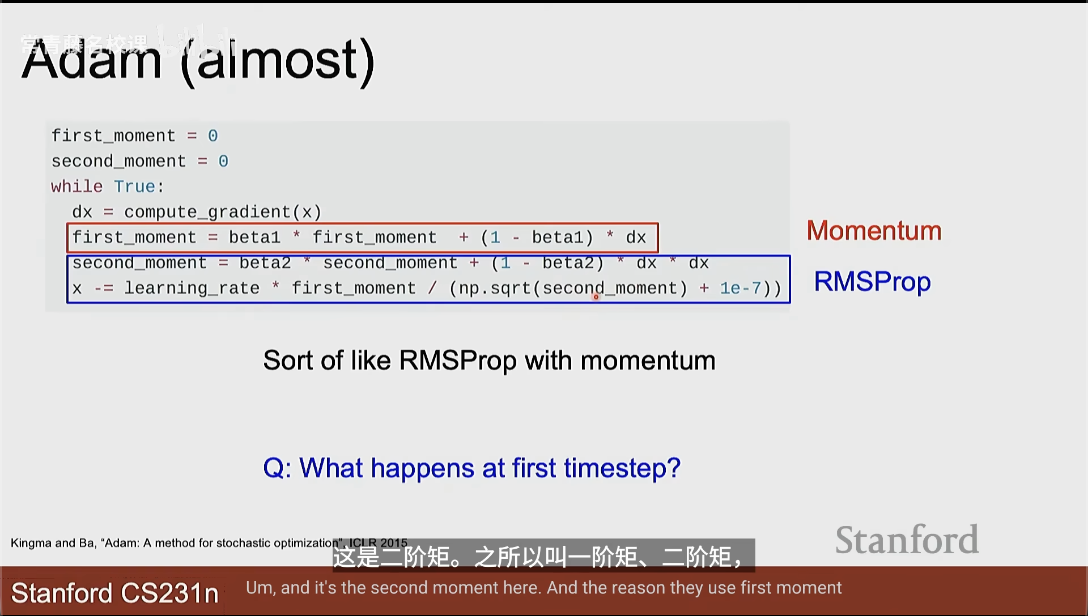
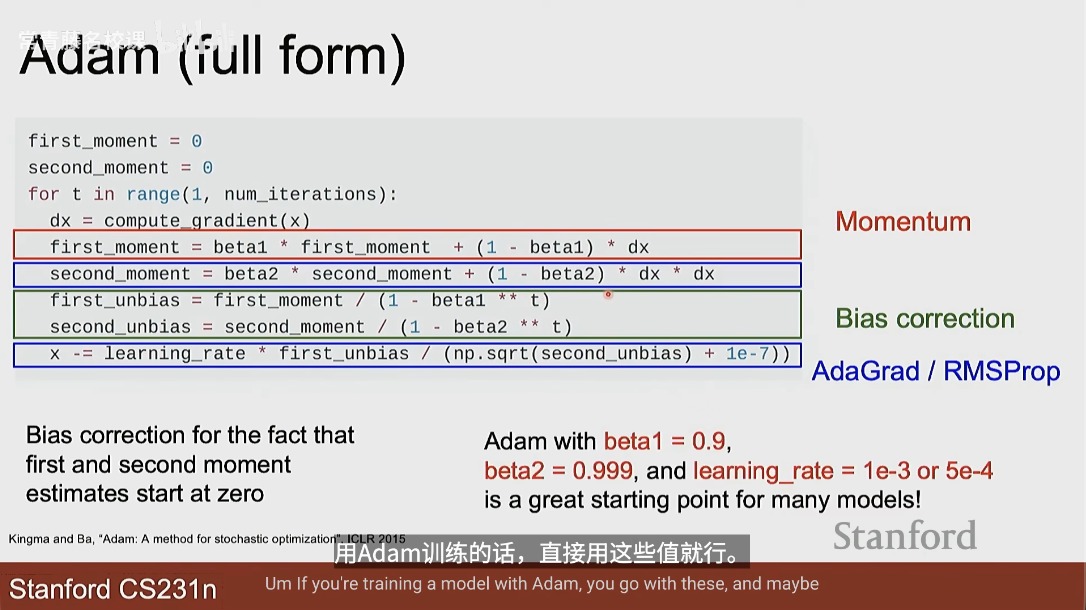
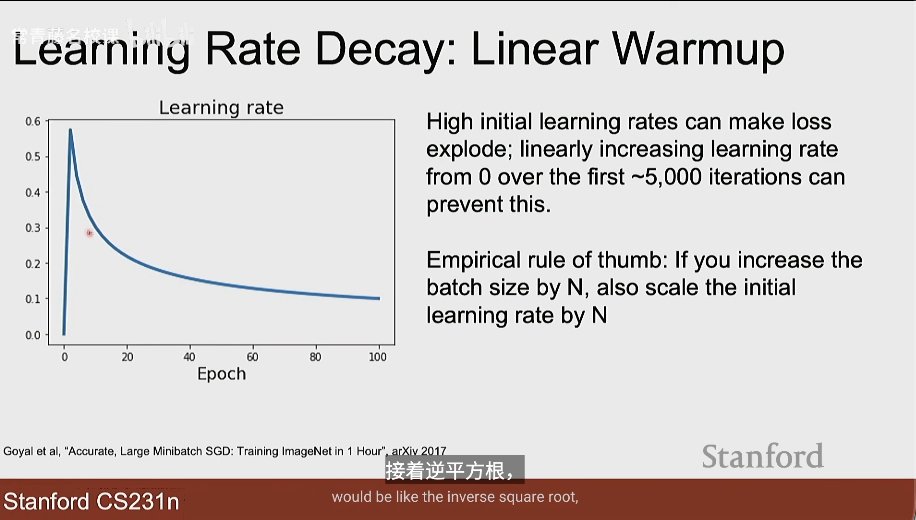
学习率 调度器 线形缩放定律
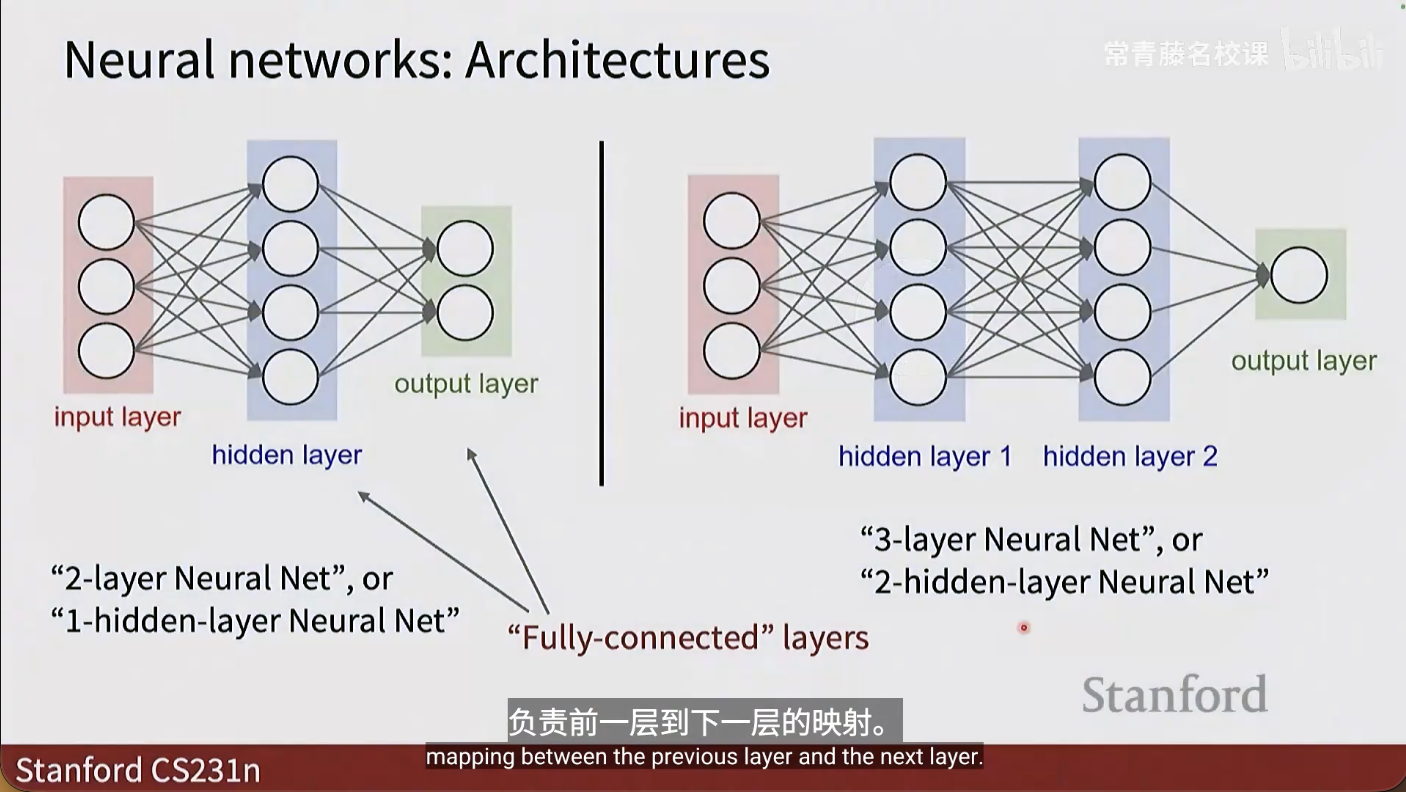
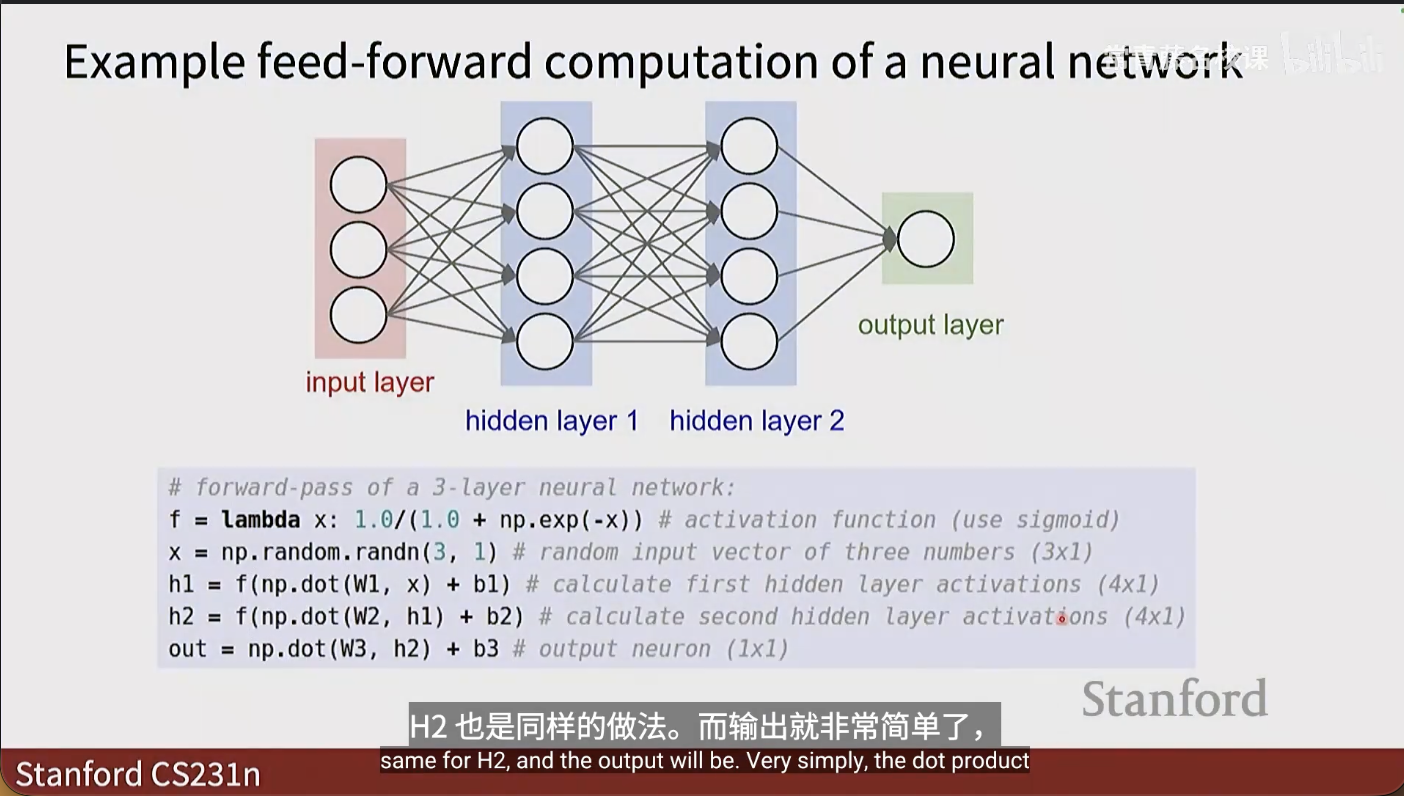
神经网络与反向传播
激活函数 Activation functions ReLU 激活函数引入非线性变换 sigmoid
调整正则化超参数
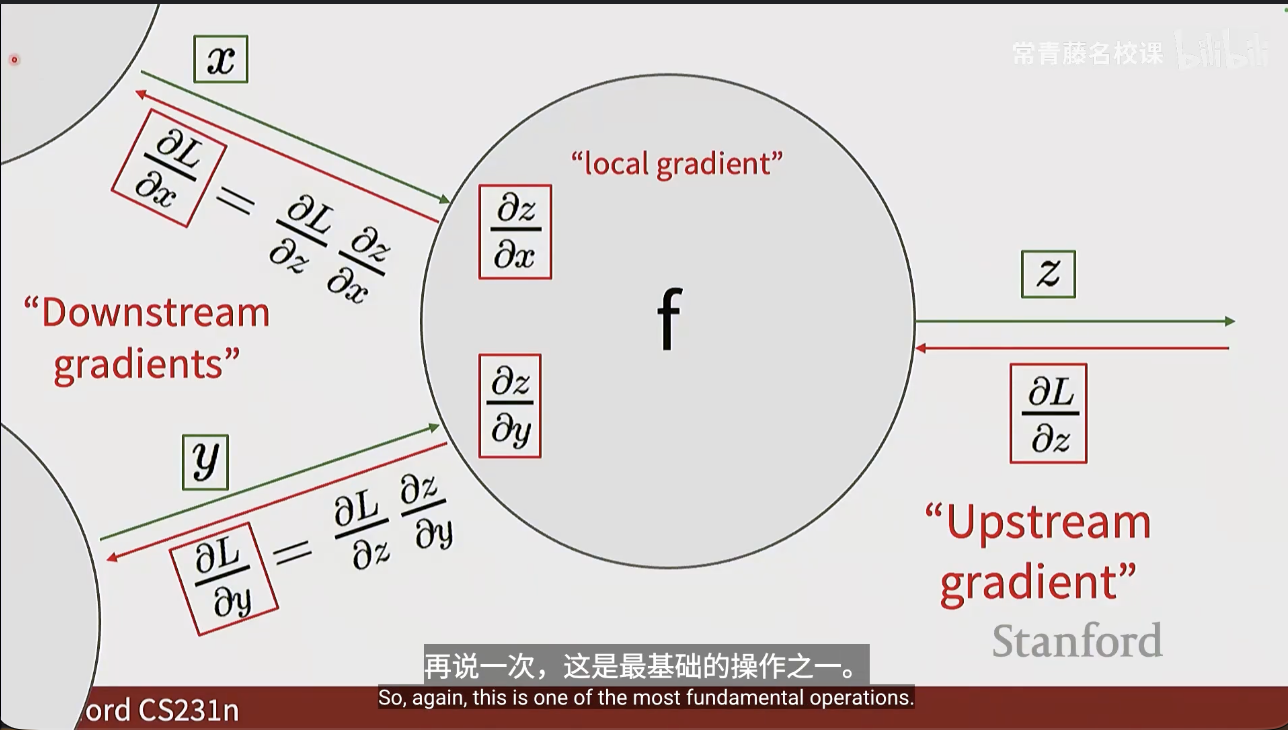
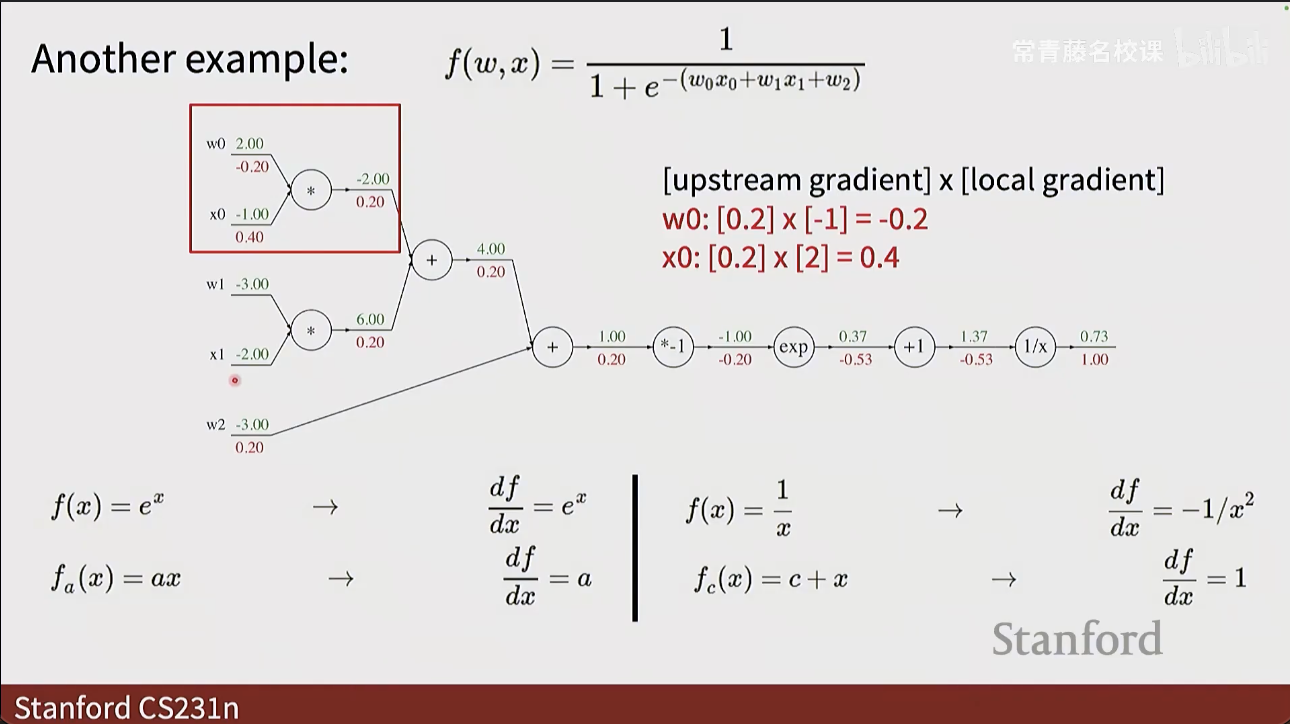
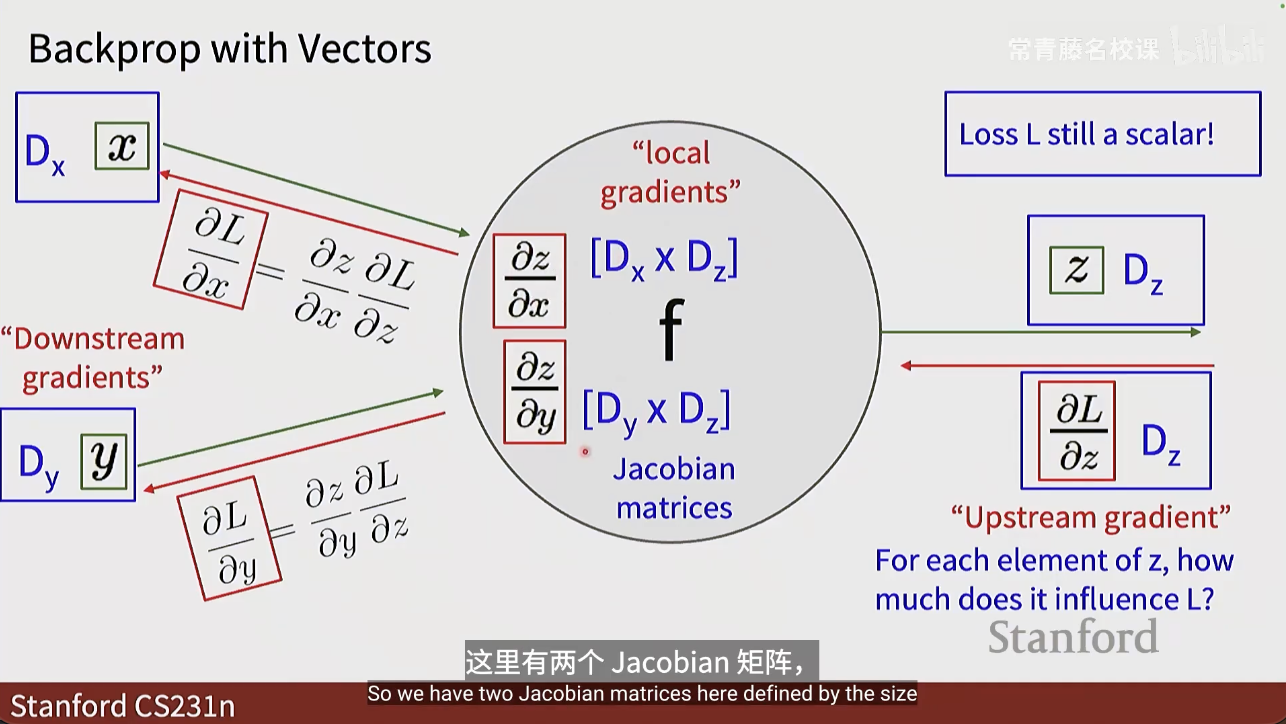
计算图
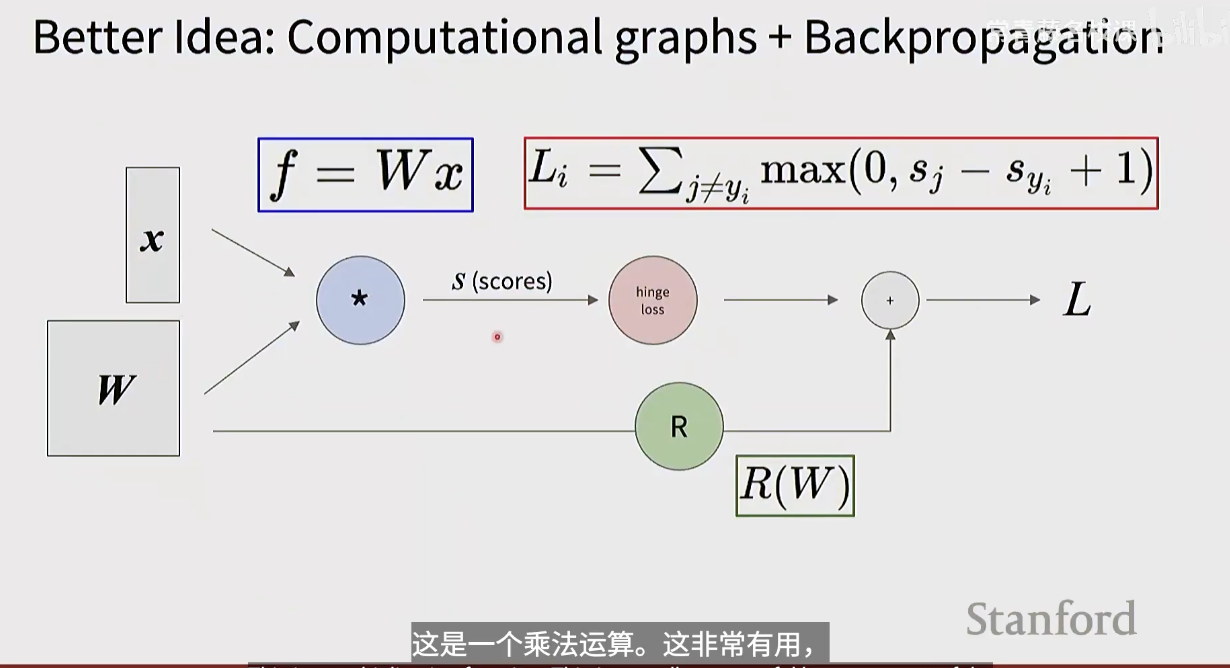
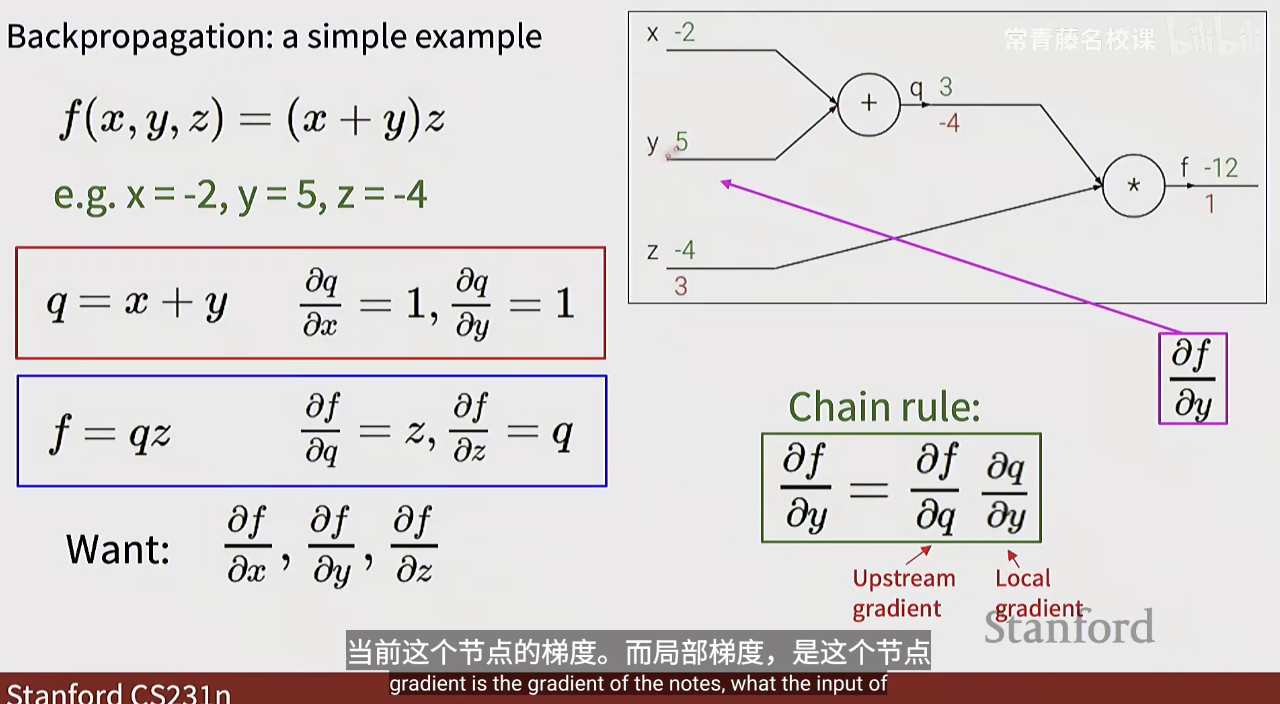
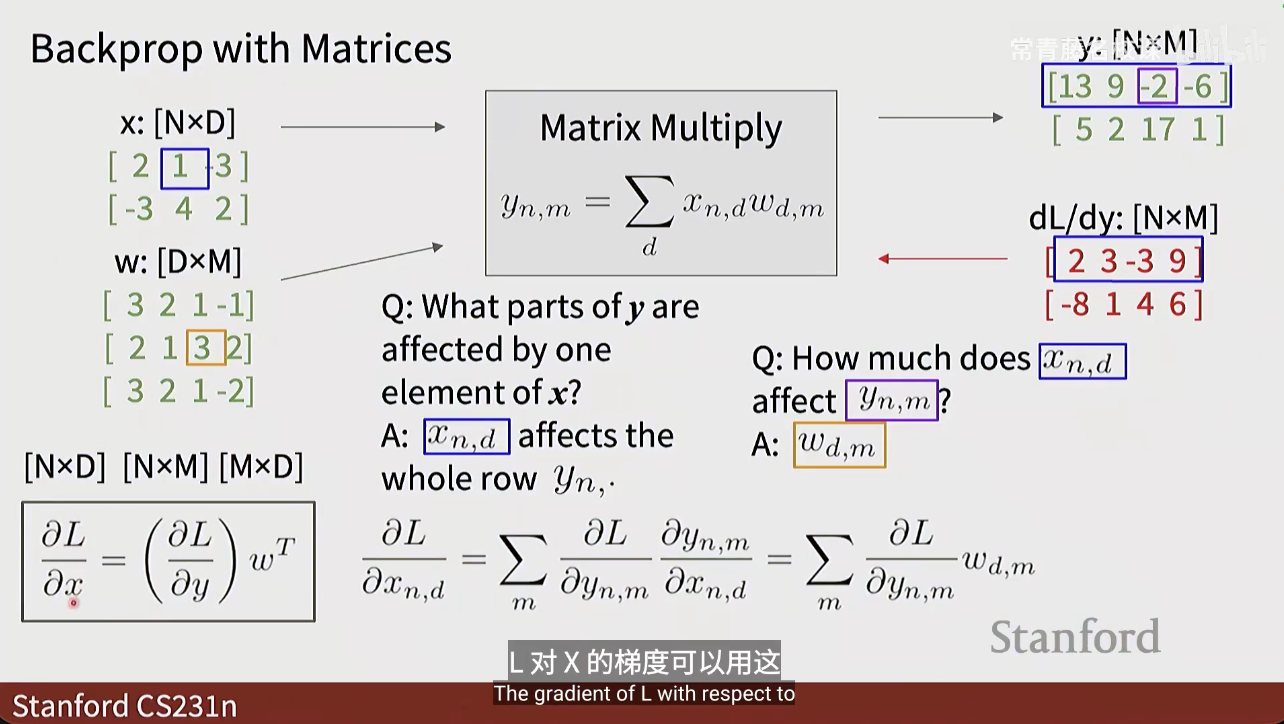
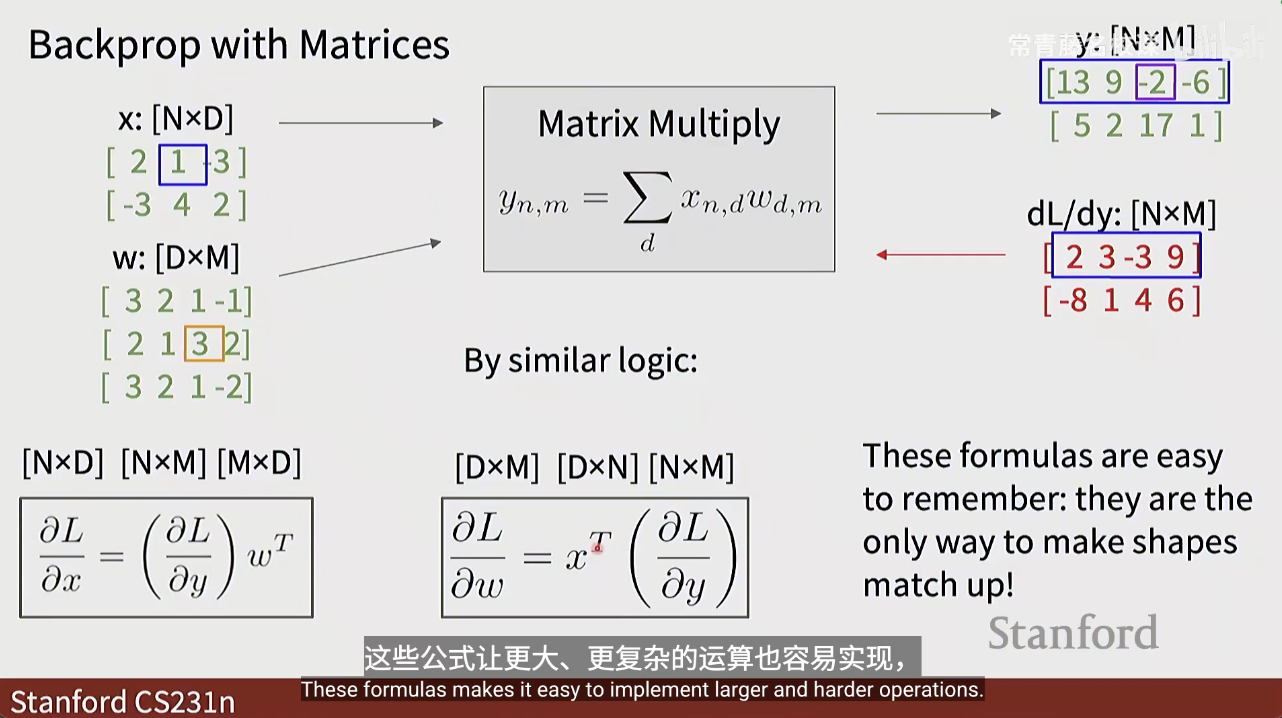
反向传播
人怎么能这么聪明
感知和理解视觉世界
卷积神经网络
算子:卷积层、池化层
特征提取范式,淘汰了
卷积网络,端到端学习方式
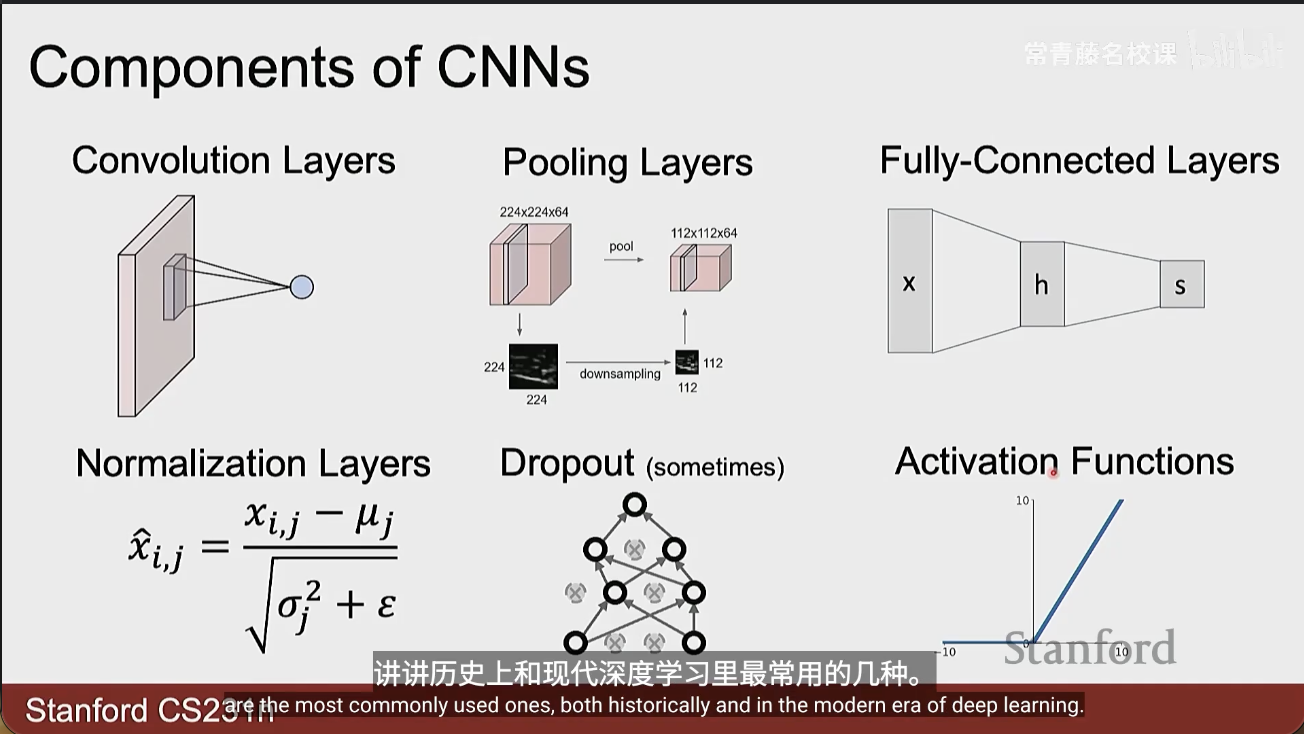
卷积层、全连接层
加多个滤波器
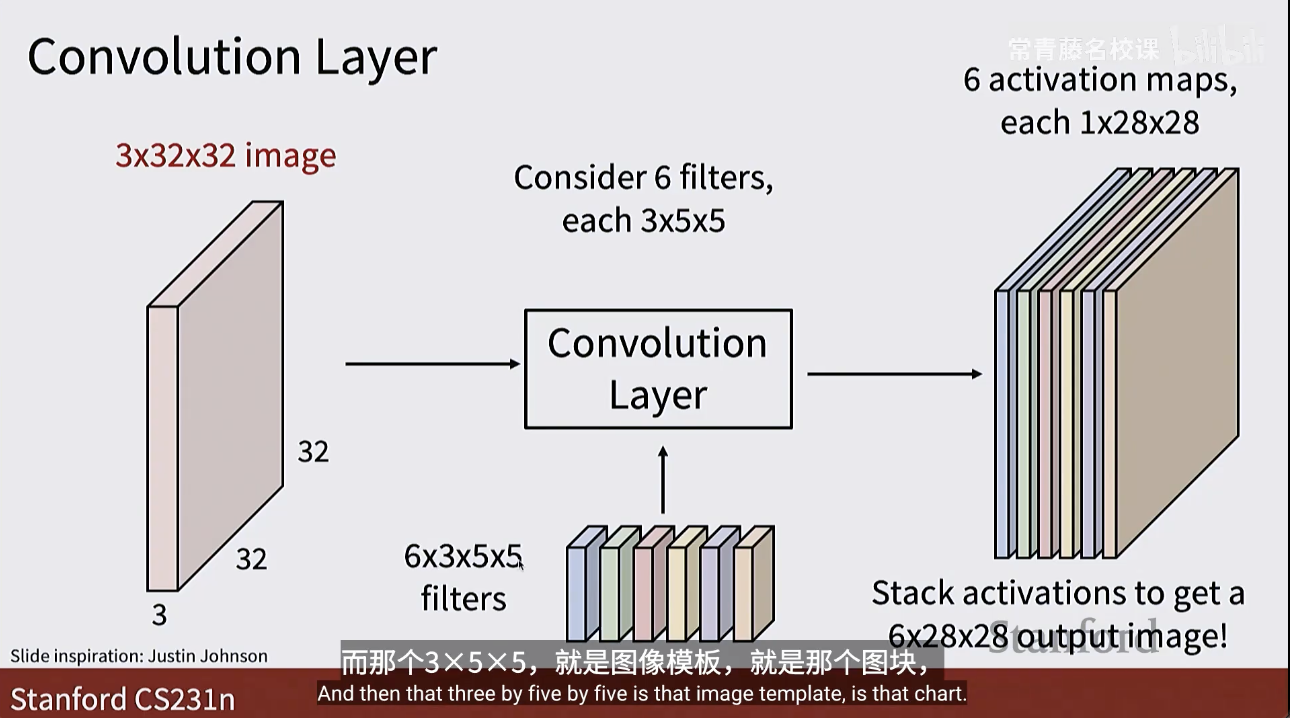
滤波器怎么来?梯度下降学习出来的
超参数:训练之前就确定好的参数,比如滤波器大小
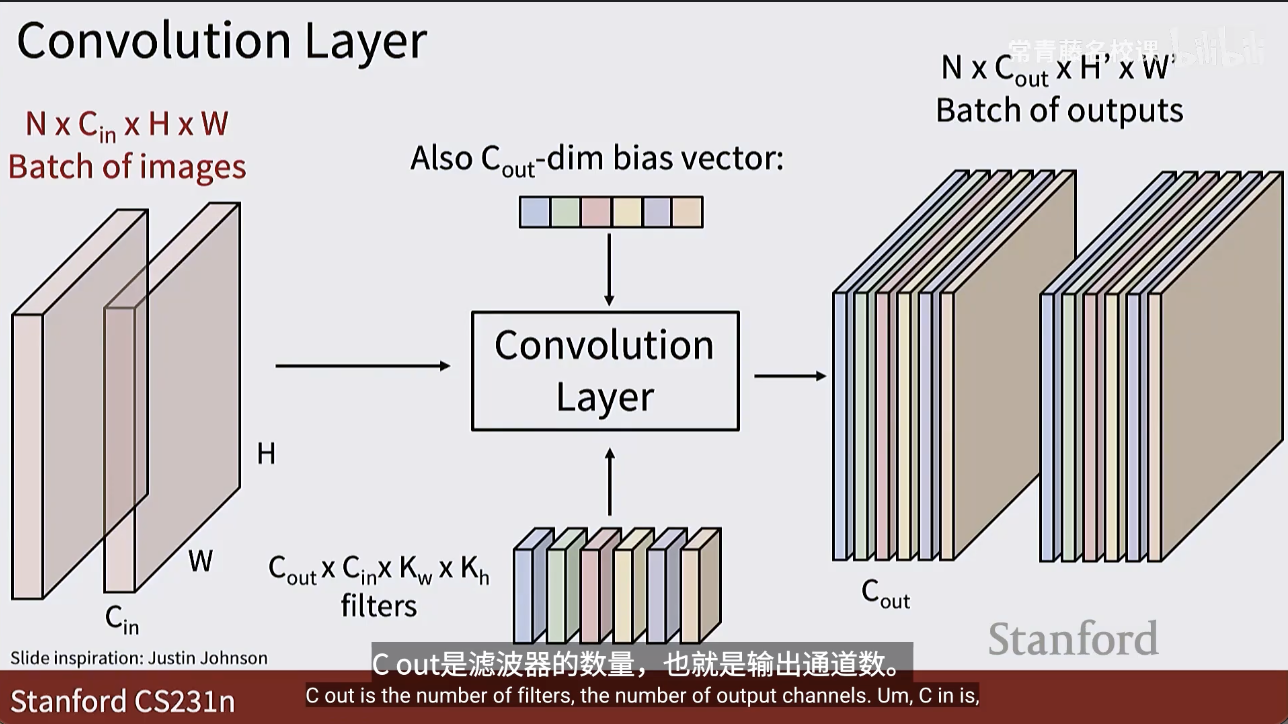
卷积层之间加激活函数,非线性提高能力
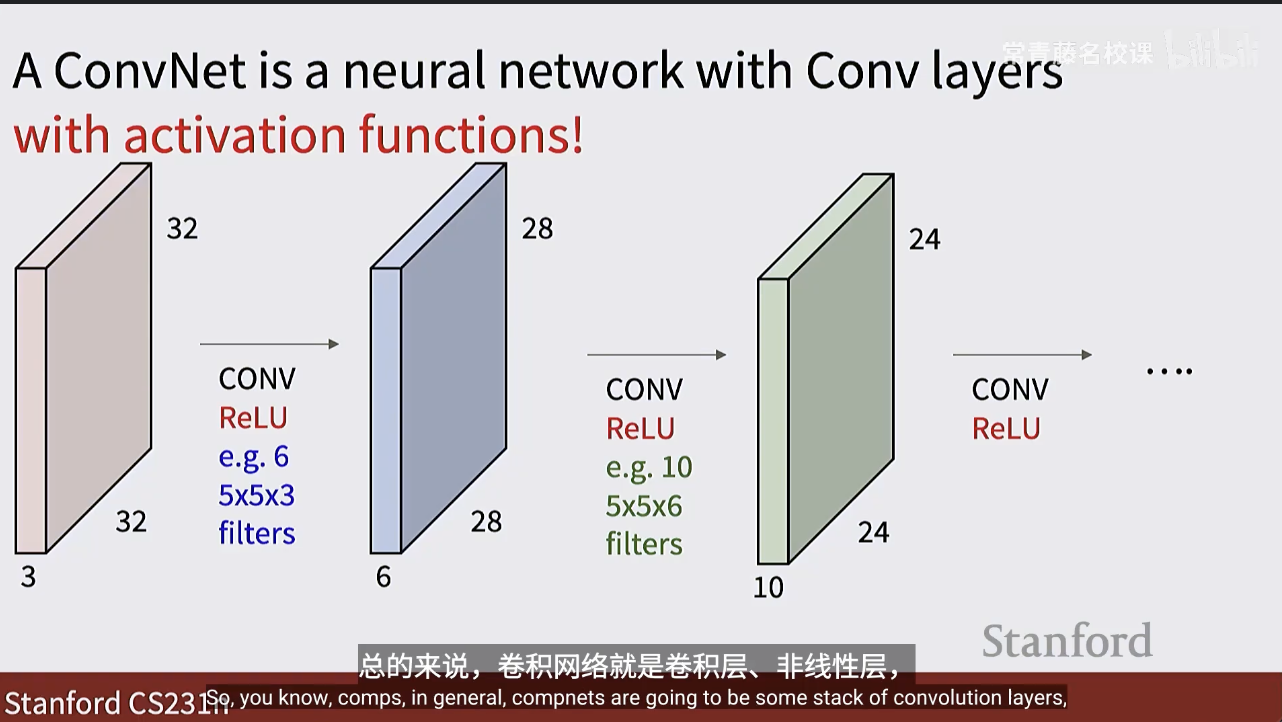
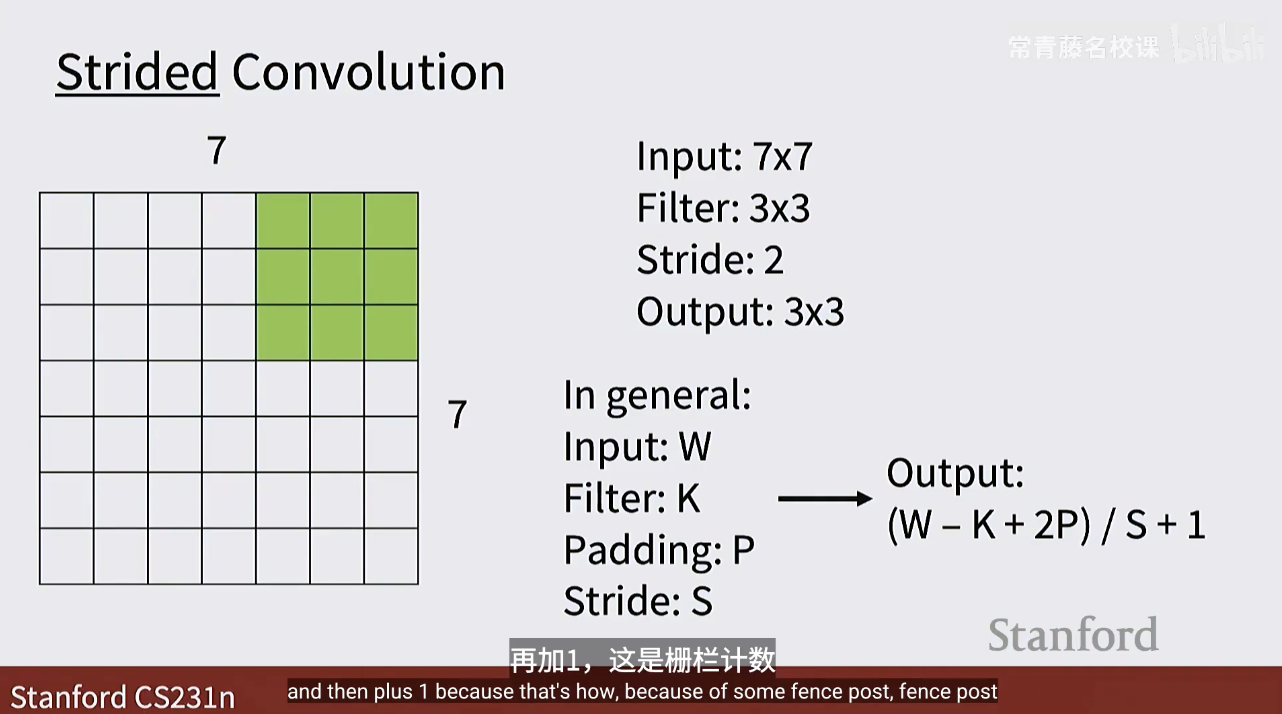
带不长的卷积,快速增大后面的感受野
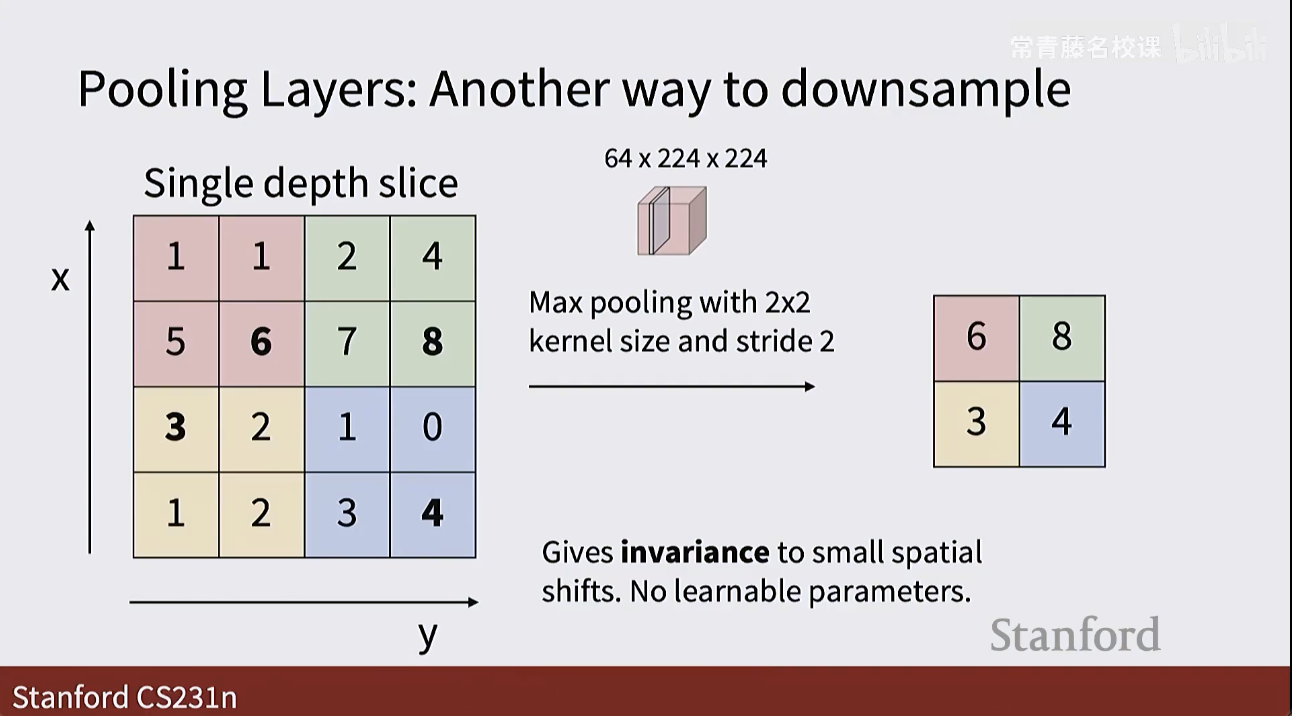
最大池化
CNN 架构
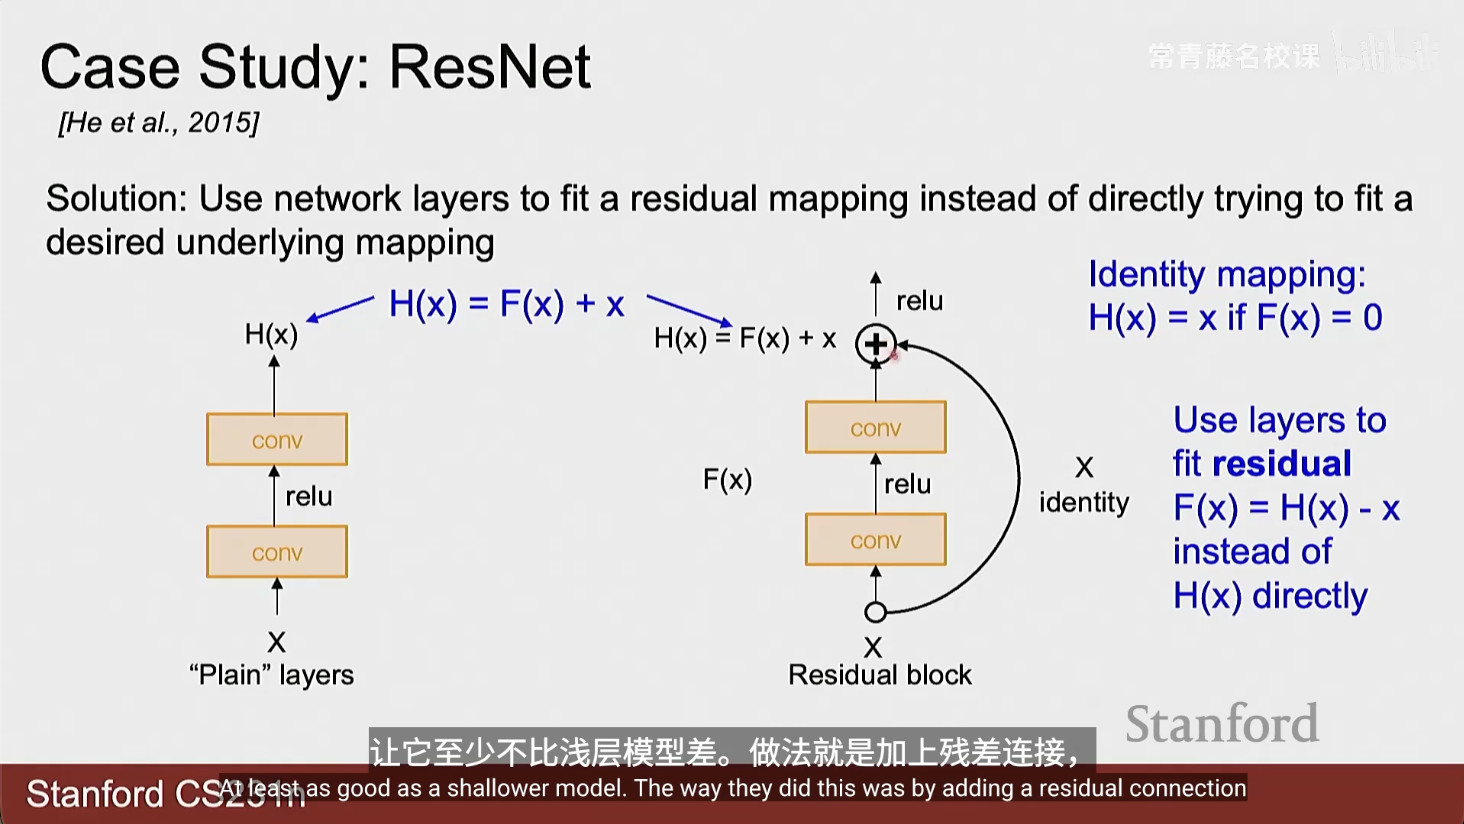
多层网络性能优化,让其不比浅层模型差
residual connection 残差连接
怎么确定初始权重 Weight Initialization
何恺明? MSRA Initialization
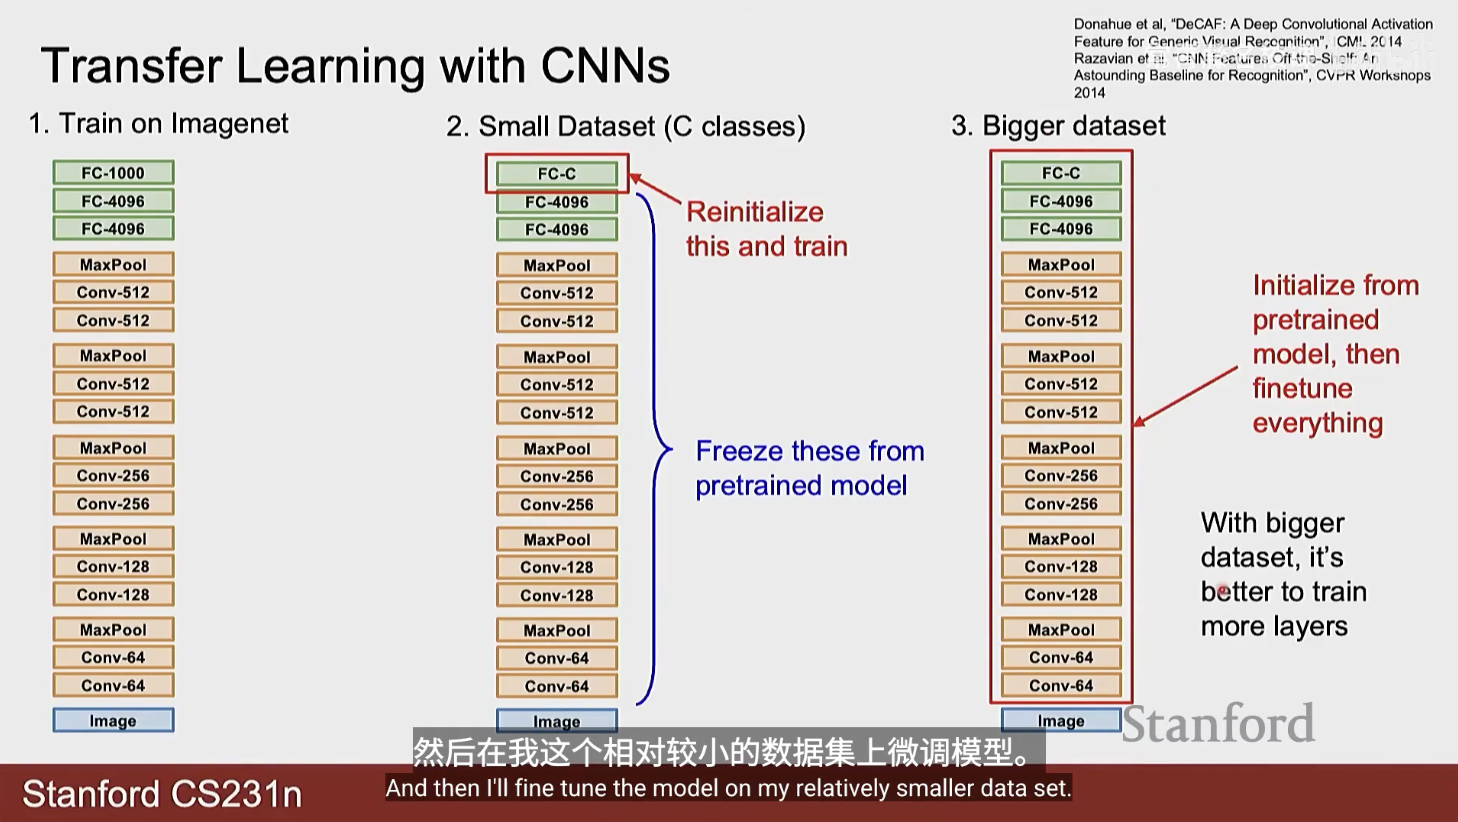
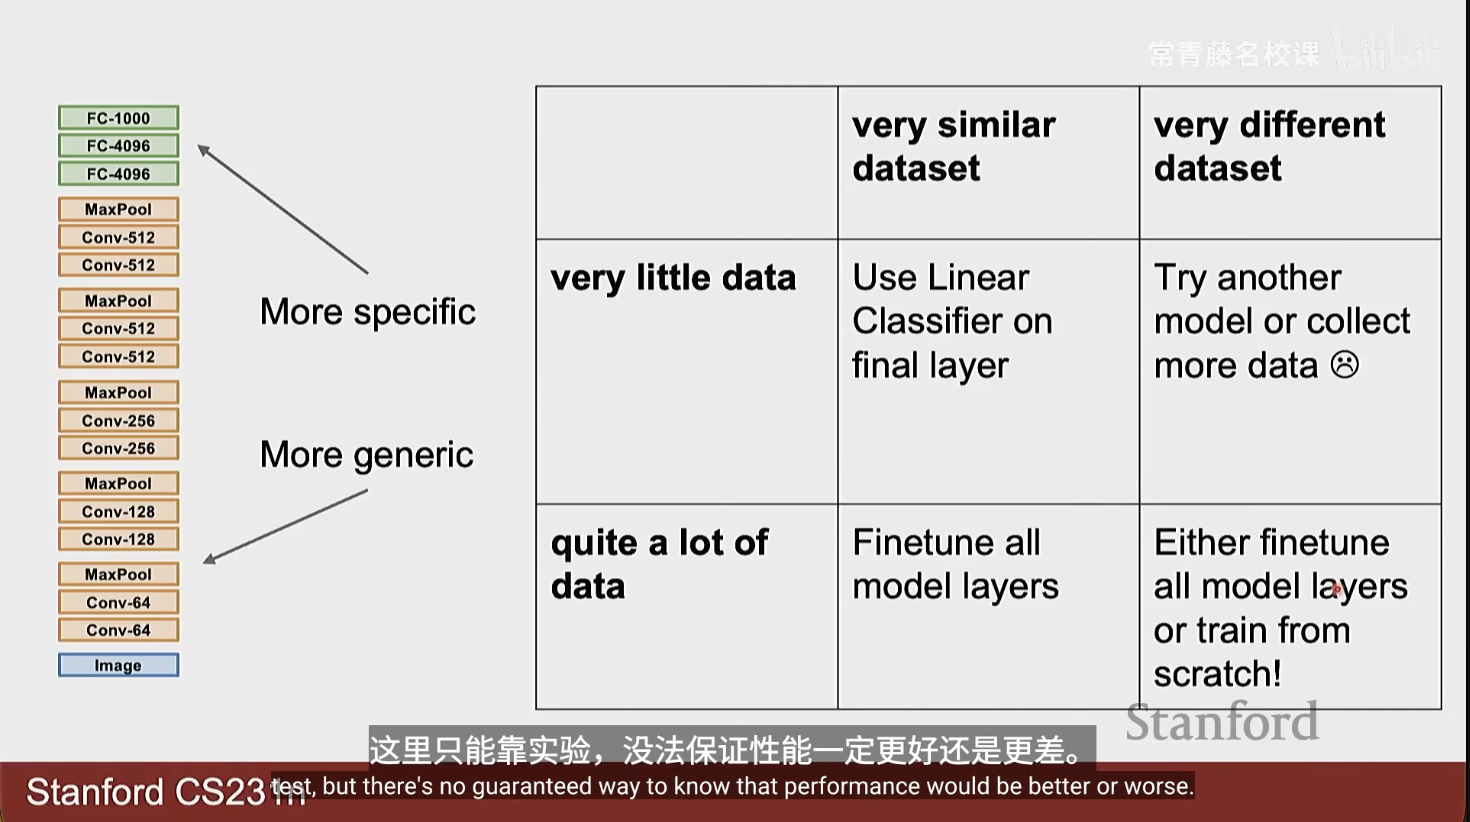
训练数据不足时如何训练 cnn
其实是预训练微调
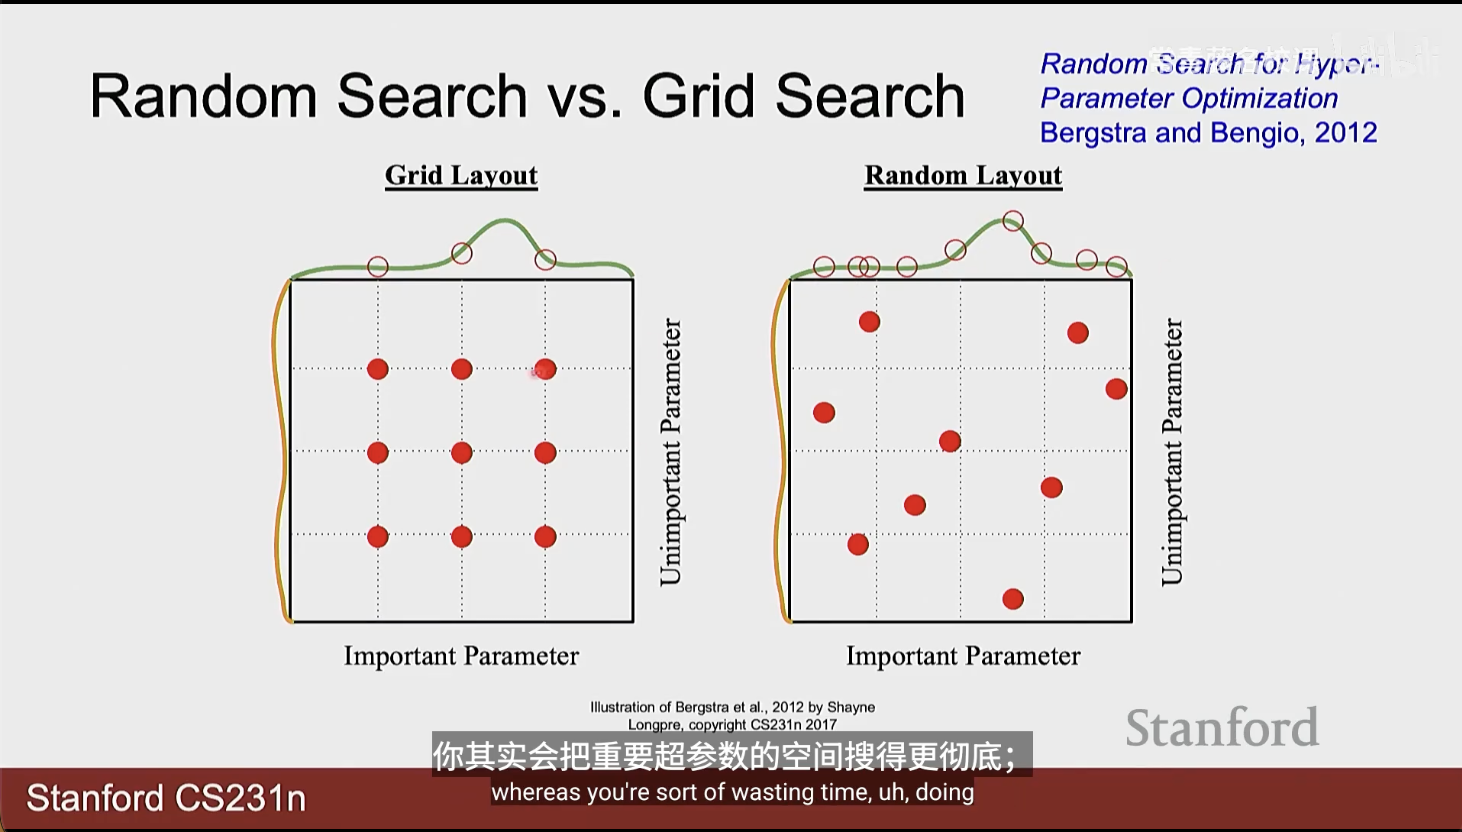
超参数选择
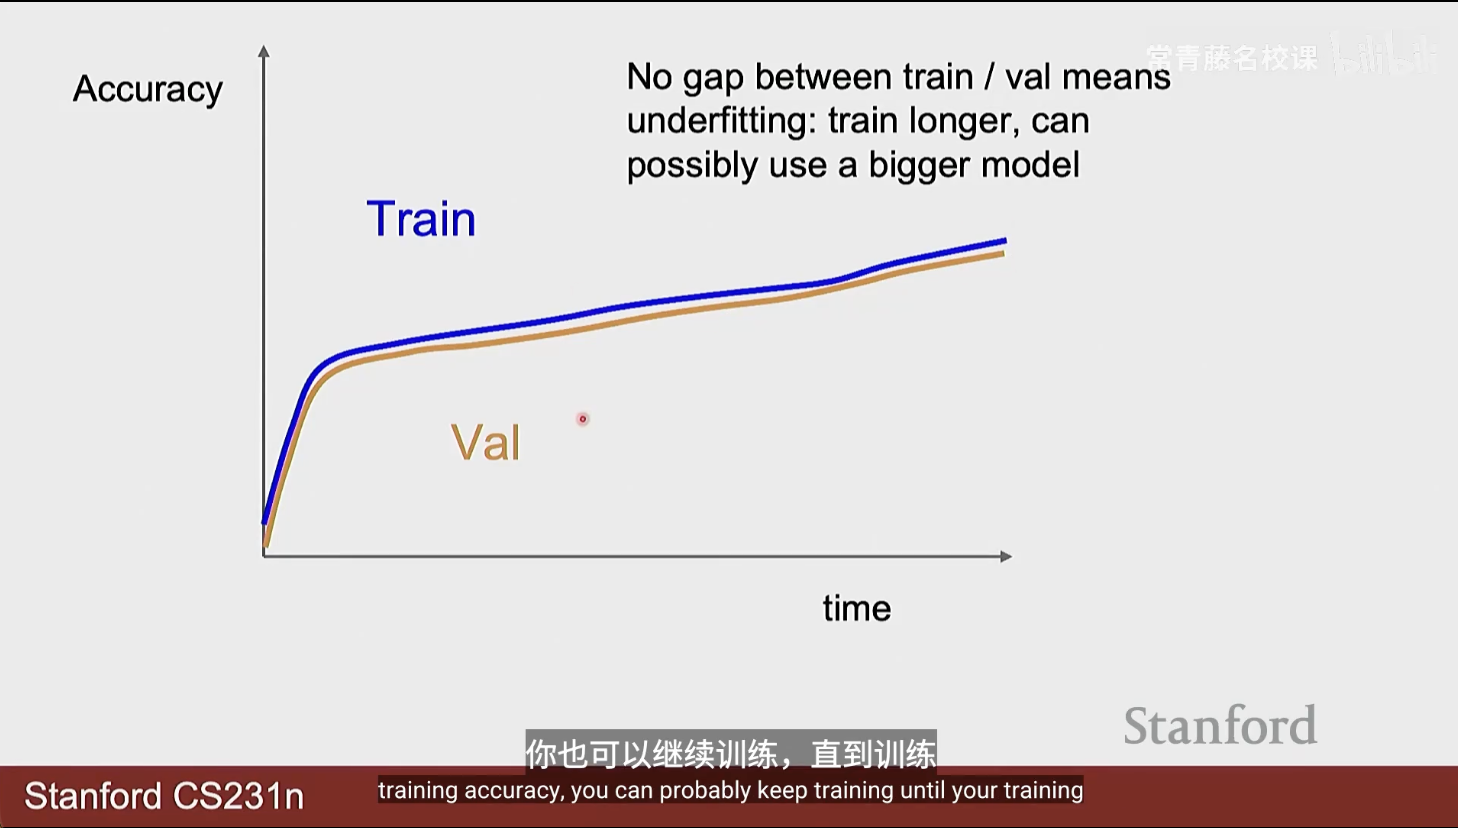 超参数搜索
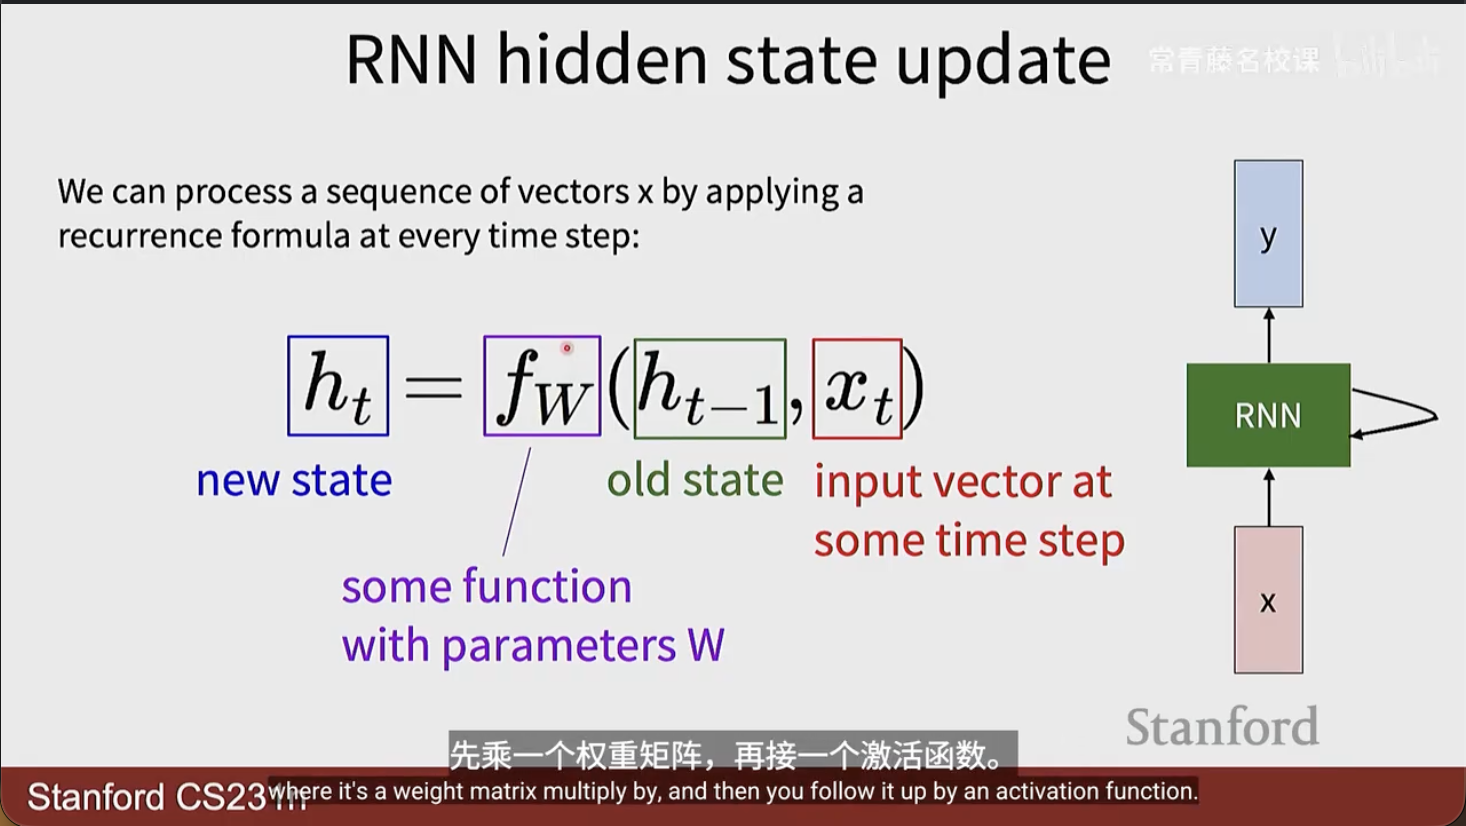
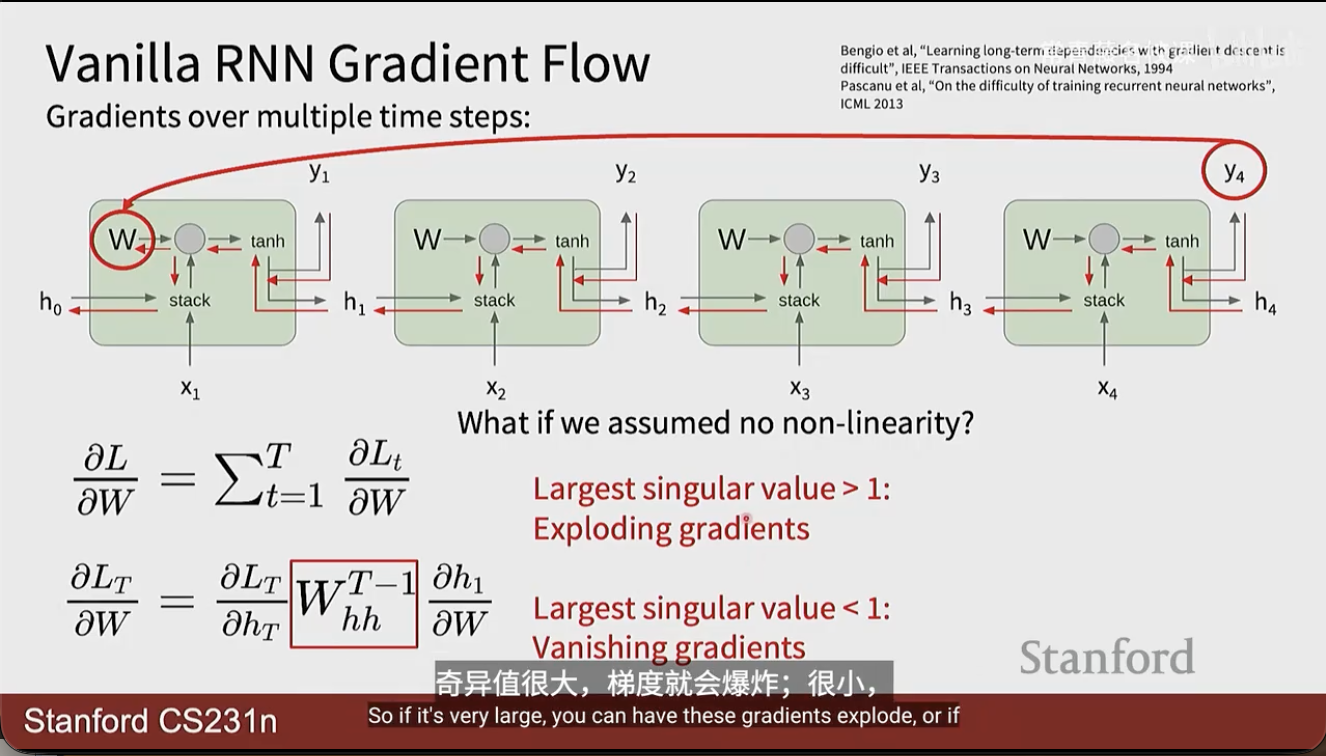
循环神经网络 RNN
工具:weights and biases
构建神经网络
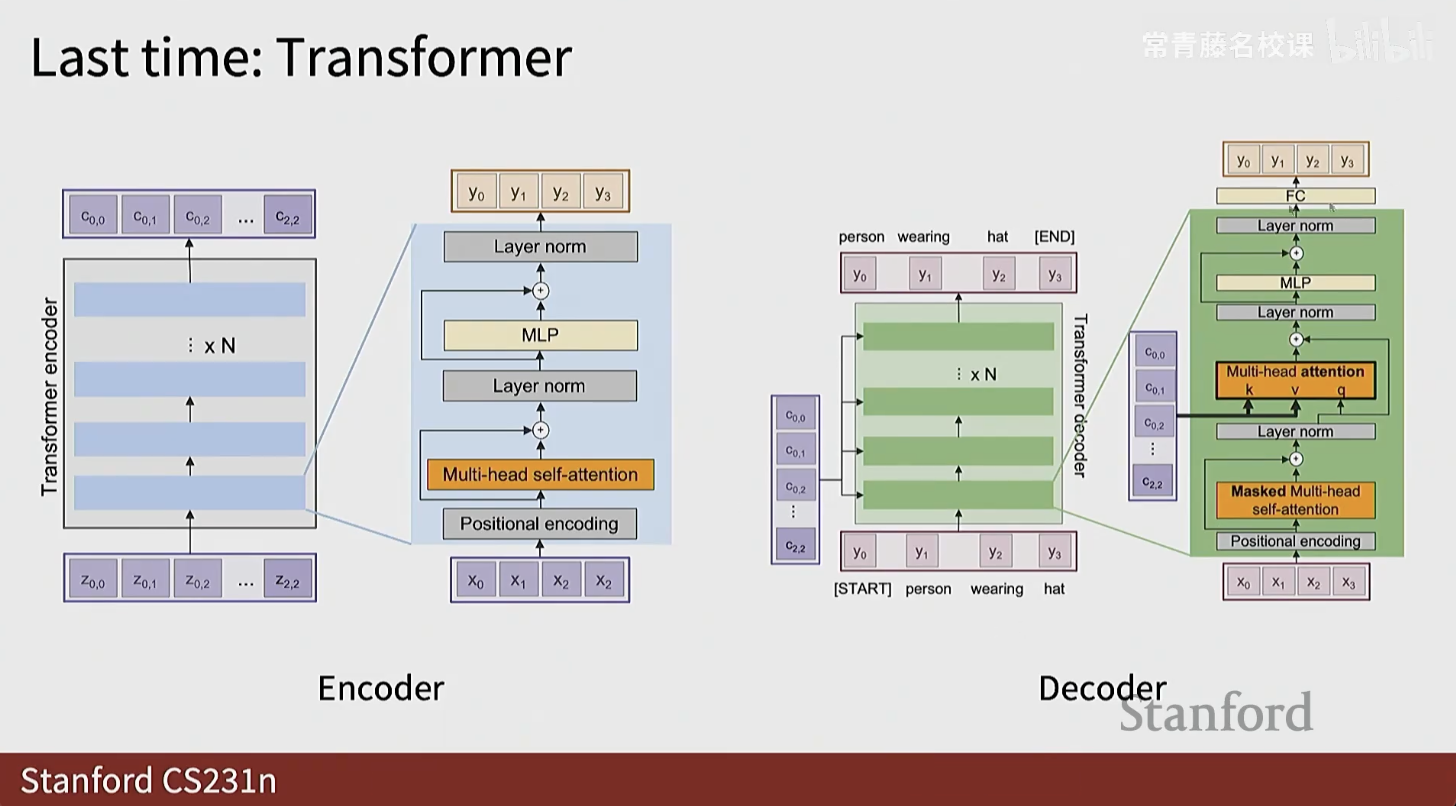
注意力与 Transformer
Attention and Transformer
Attention layer
编码器以及解码器
目标检测、图像分割与可视化
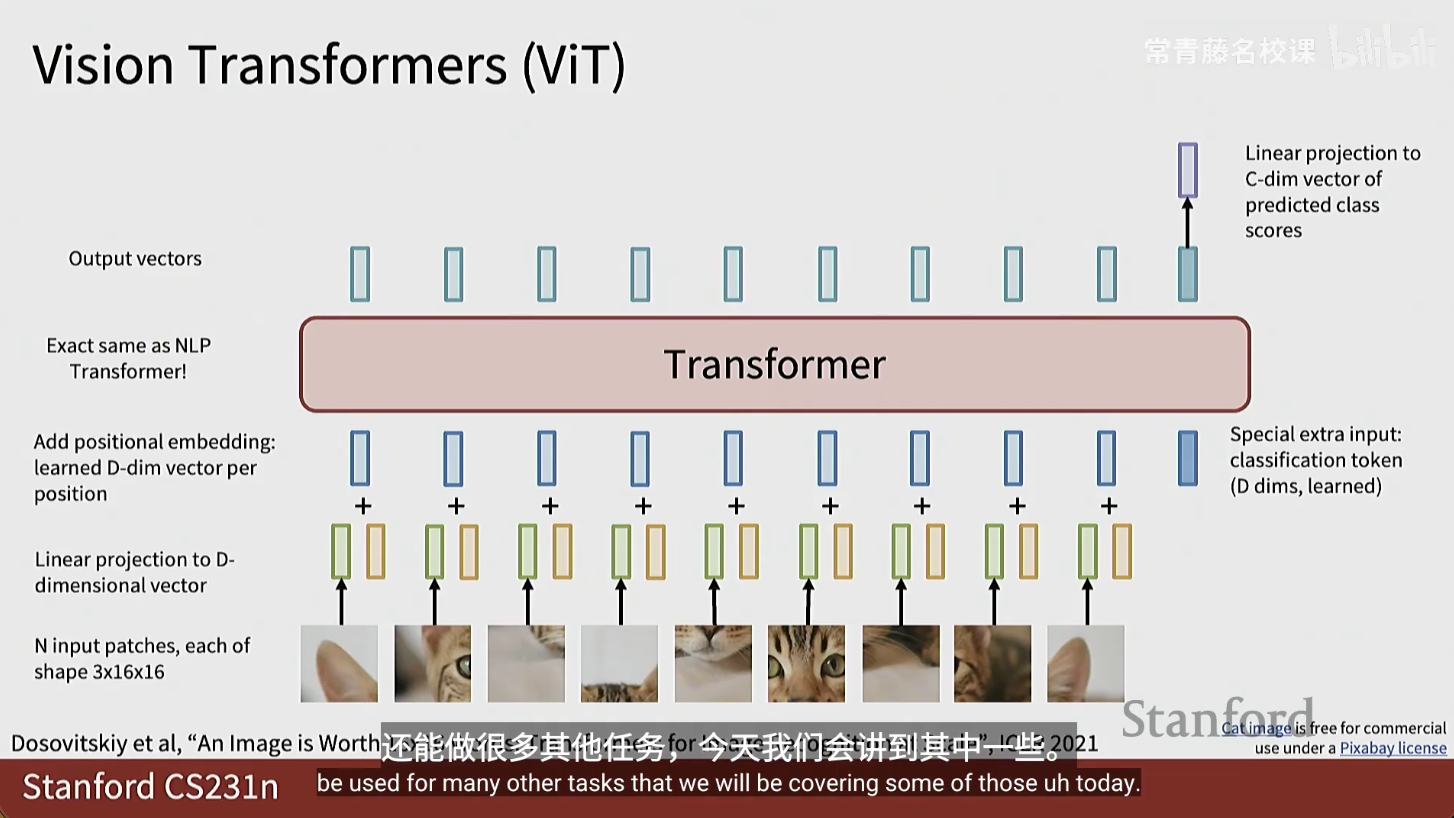
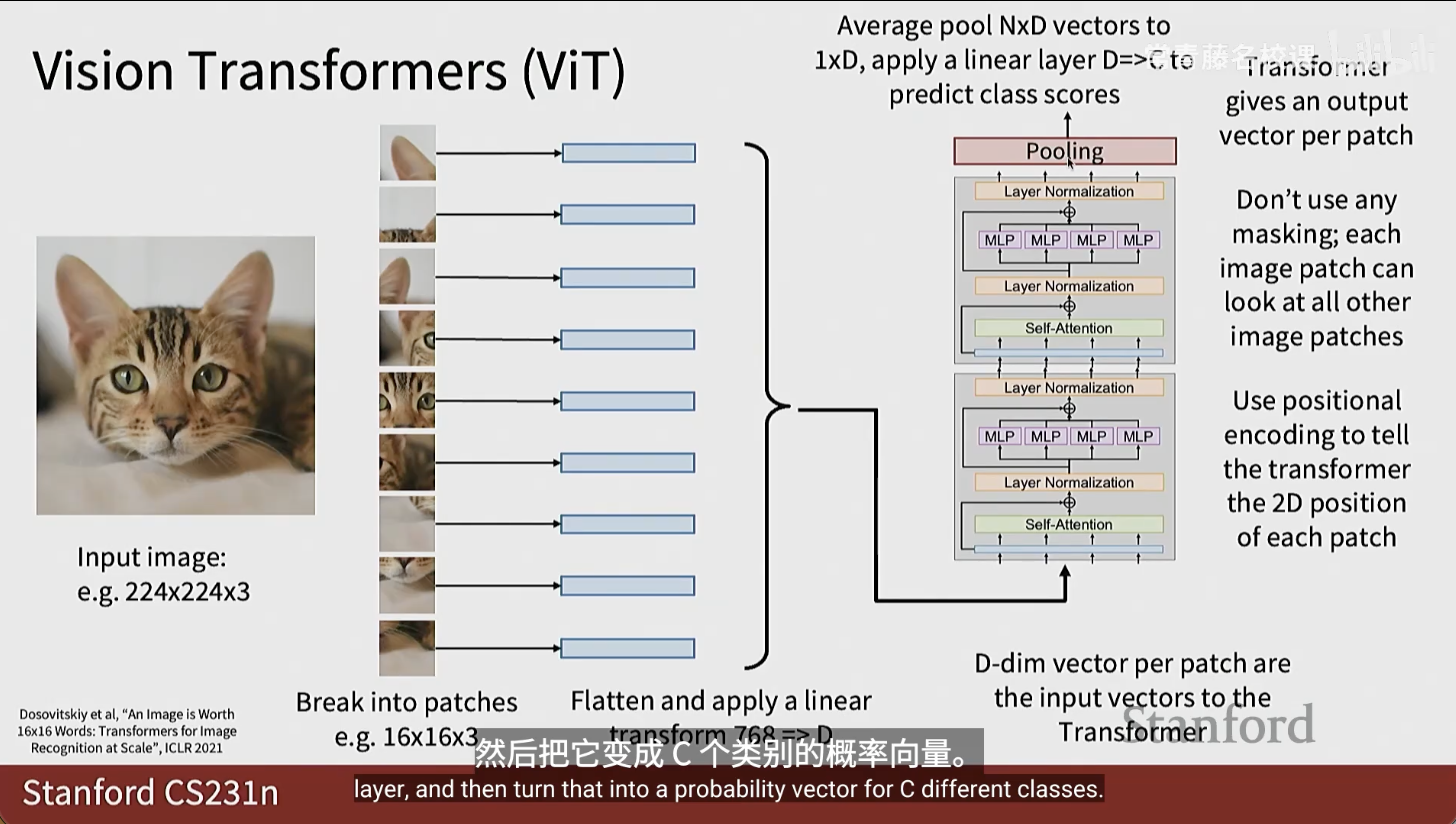
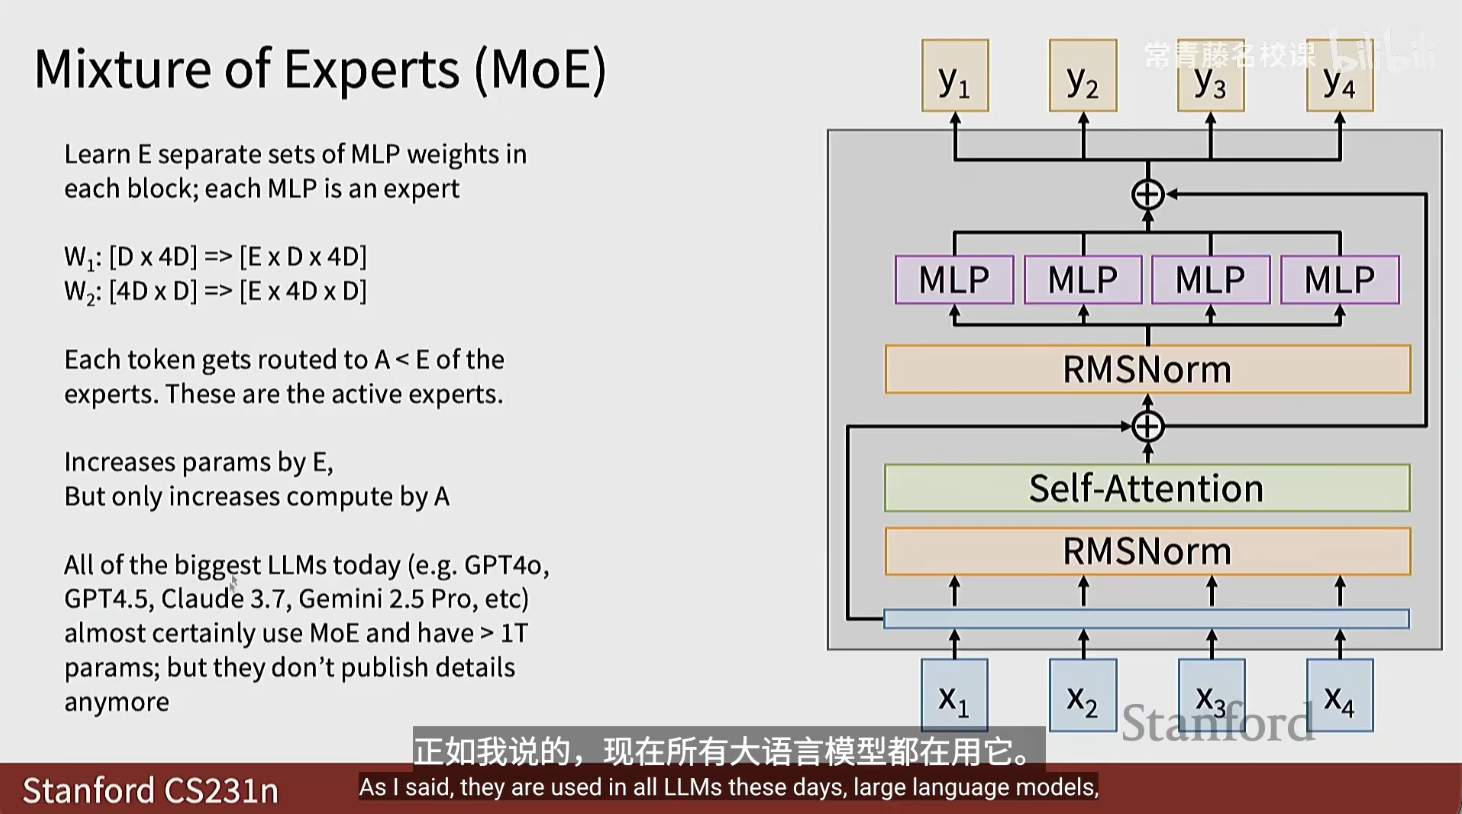
vision transformer(ViT)
patch➡️token➡️add position ➡️
全卷积网络
语义分割
Object Detection 实例分割
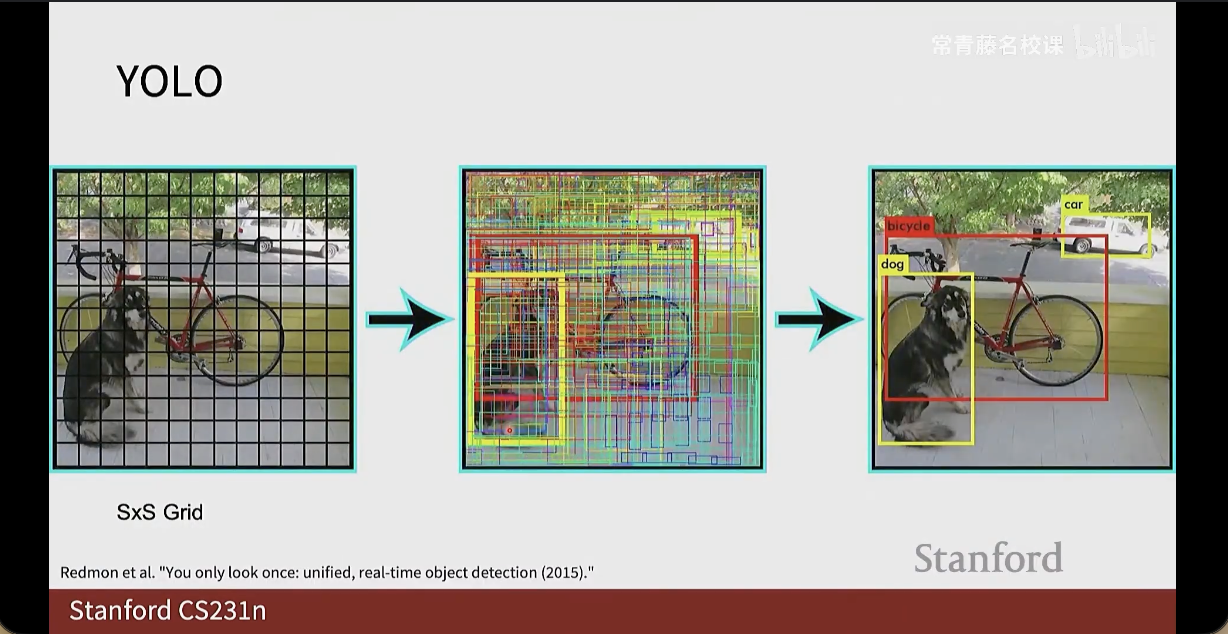
Single-Stage Object Detectors
YOLO
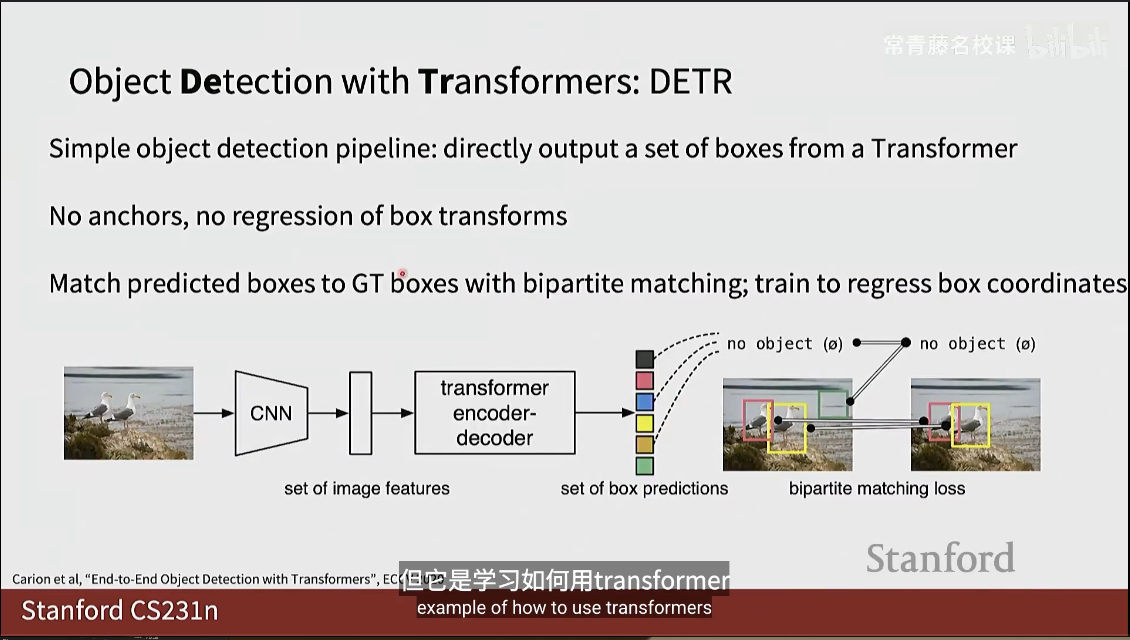
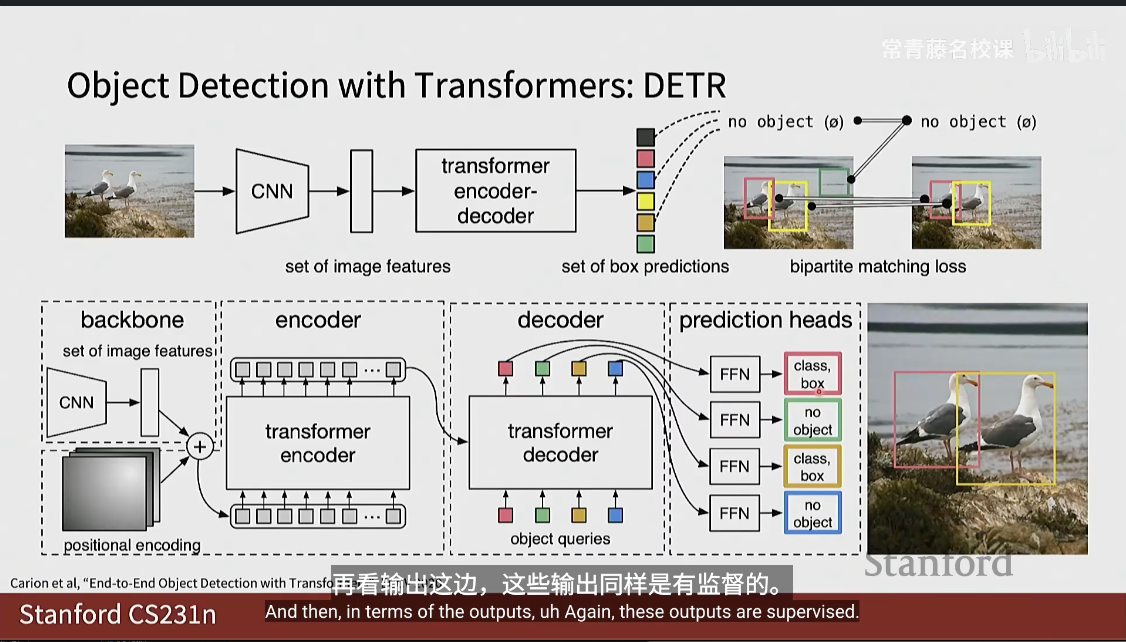
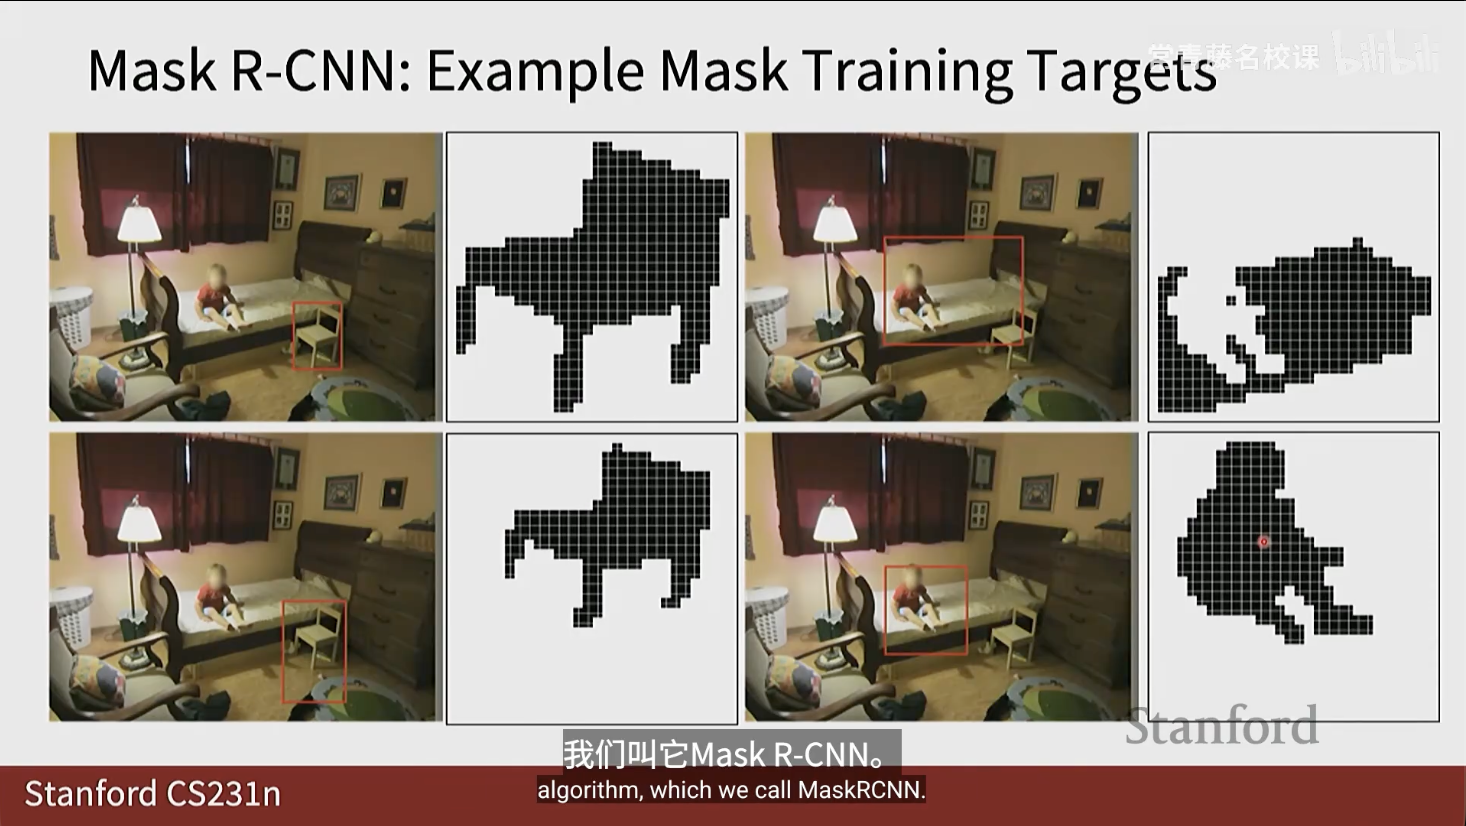
Mask R-CNN
Mask 掩码
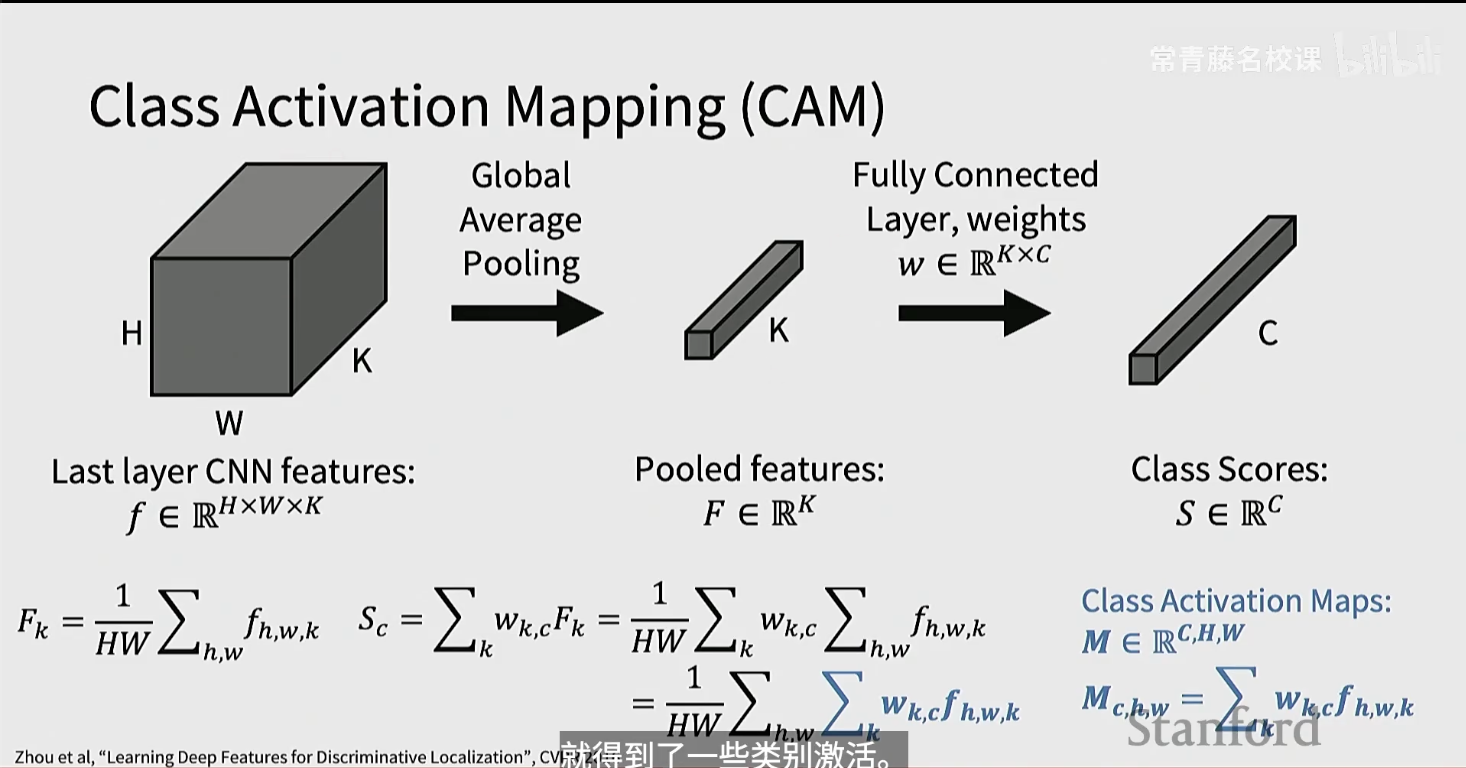
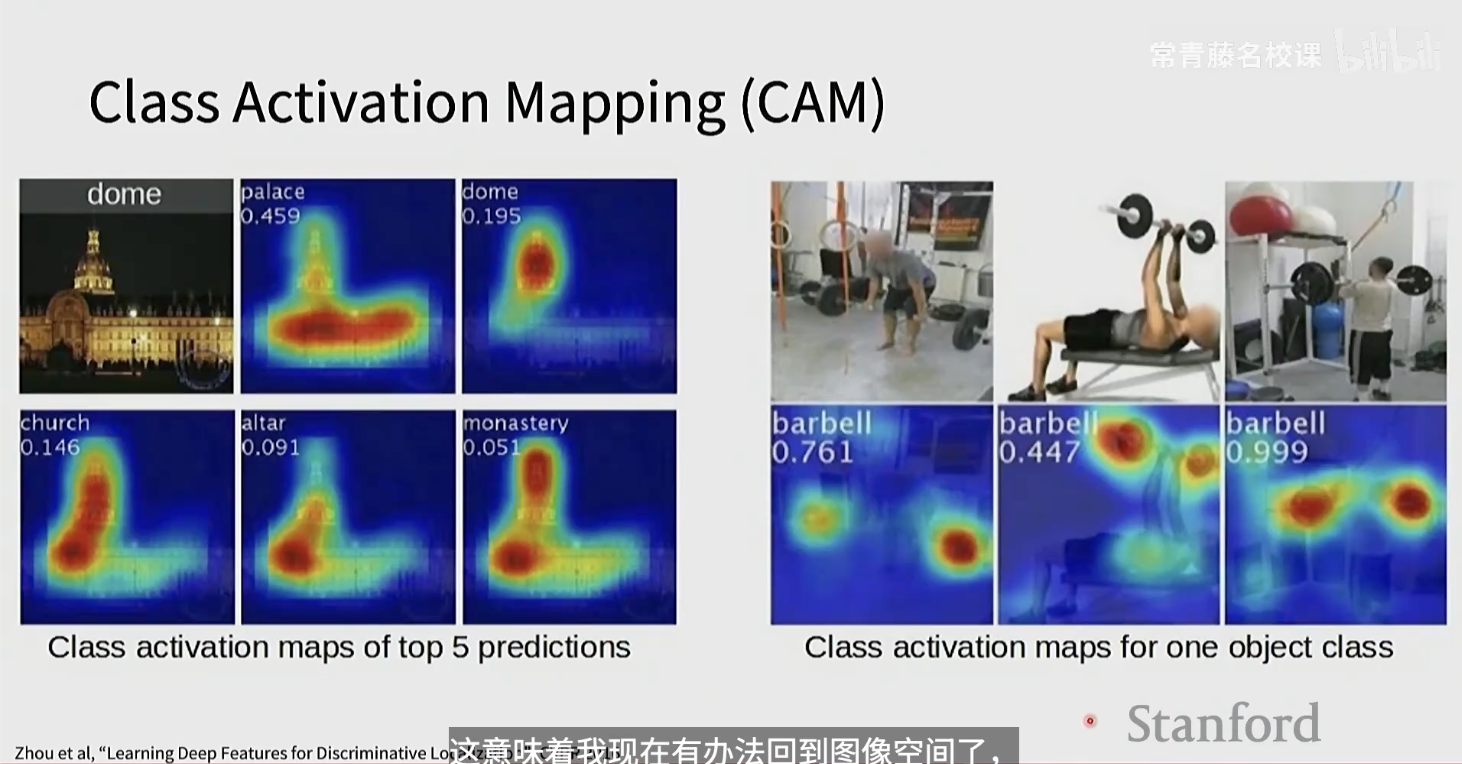
Class Activation Mapping (CAM)类激活图算法
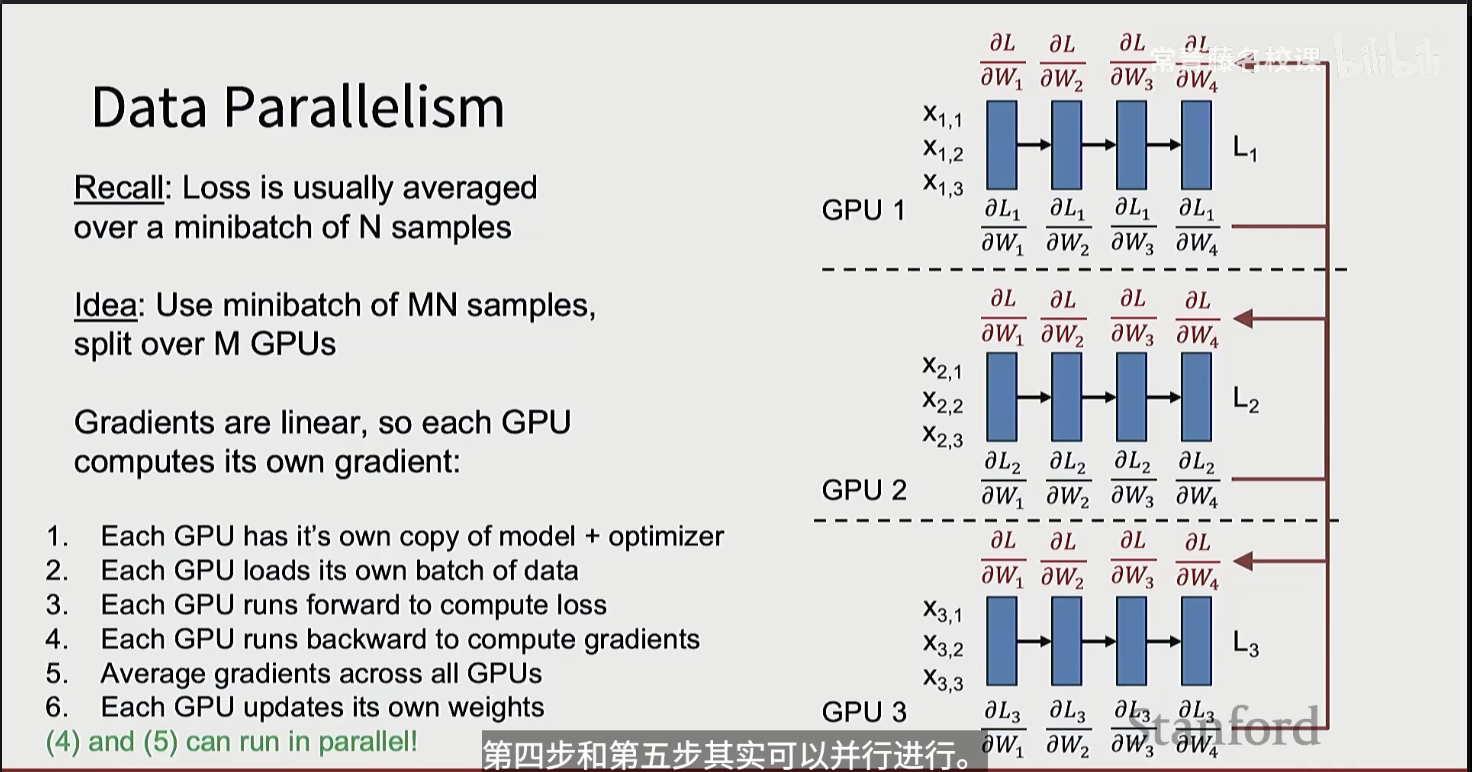
大规模分布式训练
GPU 用于并行计算
TPU 训练
梯度运算可以并行
Self-Supervised Learning 自监督学习
不用手工标注的数据集
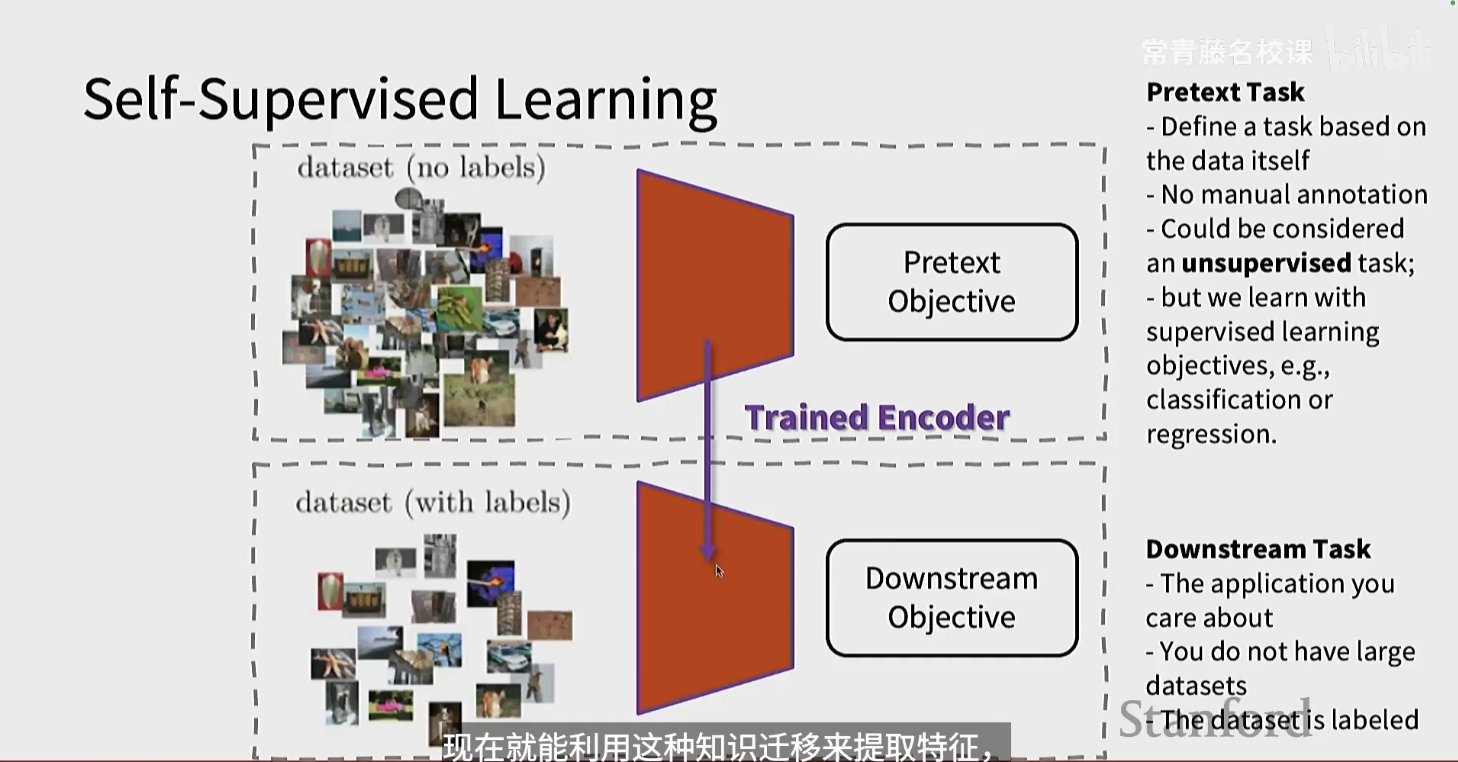
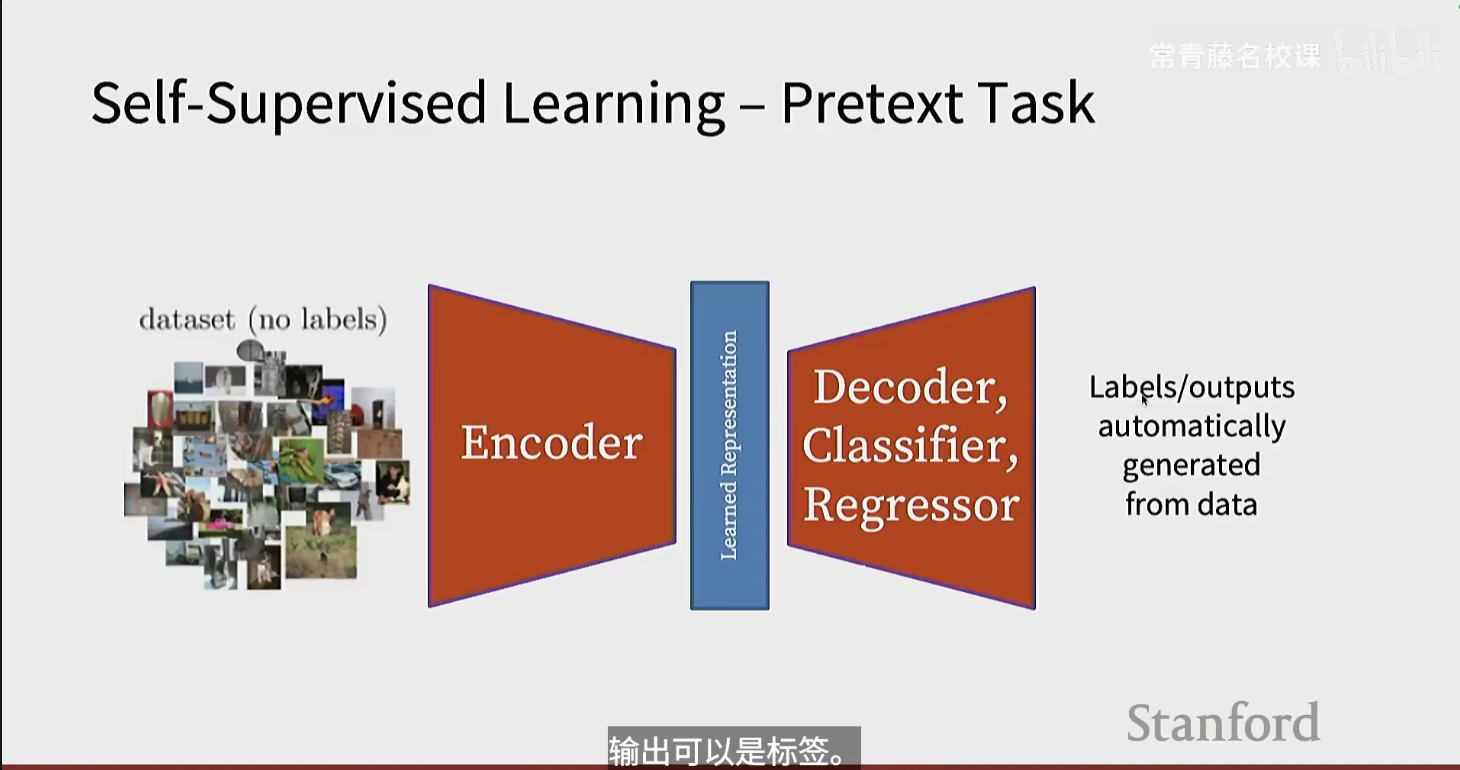
predict rotation
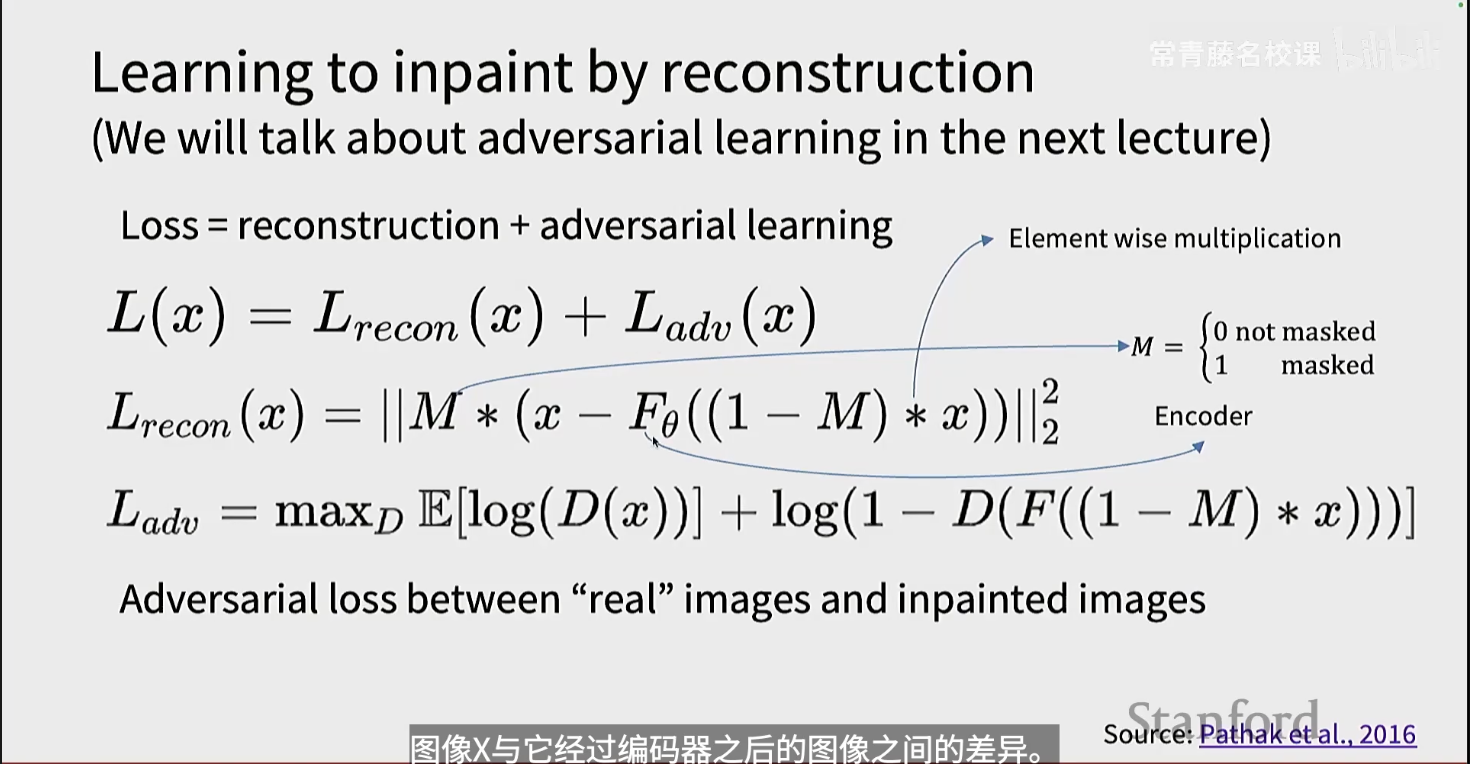
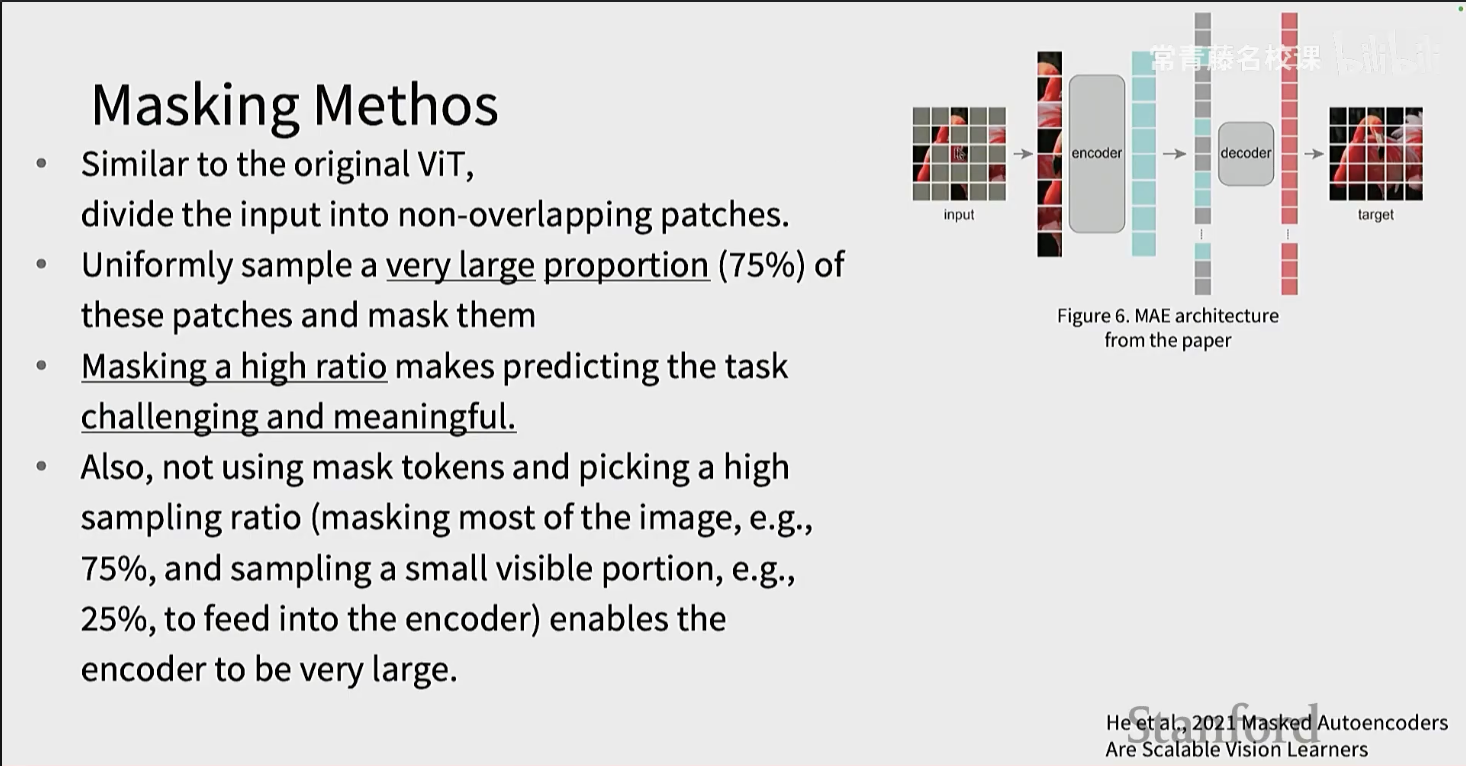
掩码自编码器 MAE
SimCLR MoCo DINO
Generative Models 生成模型
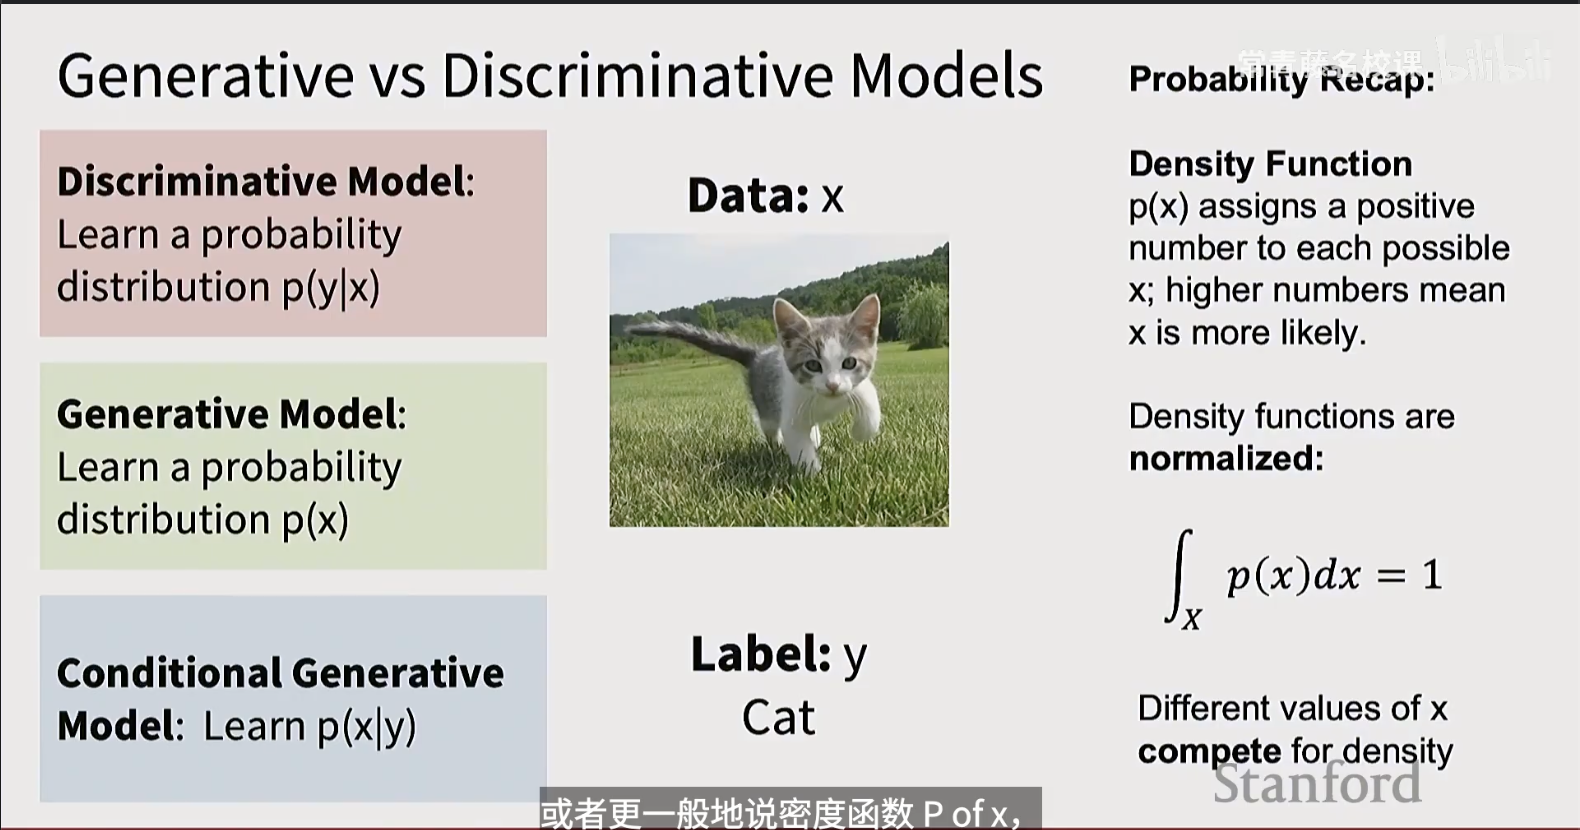
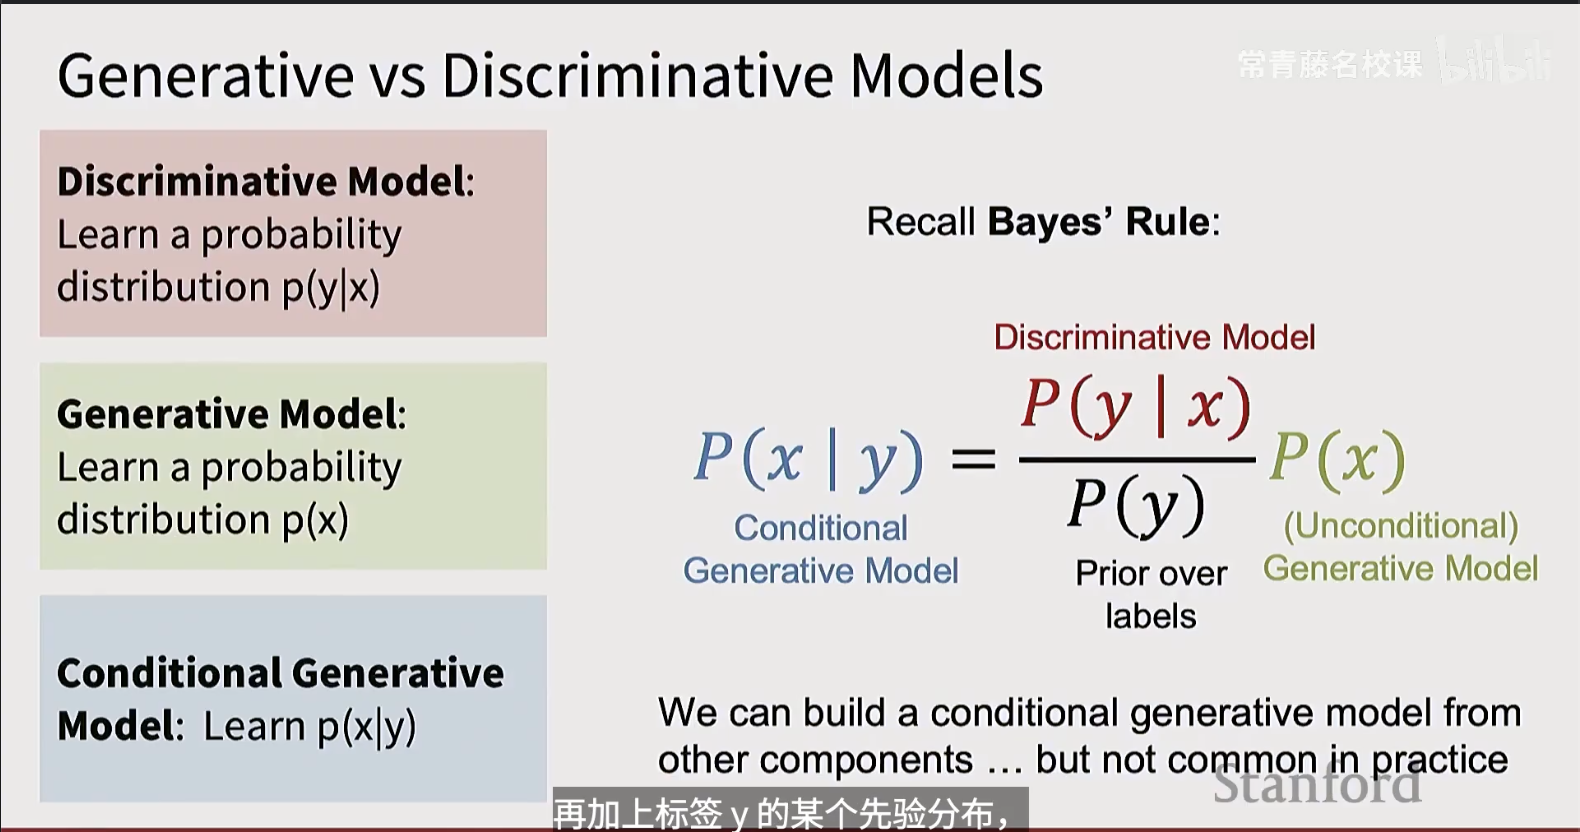
贝叶斯法则 关联
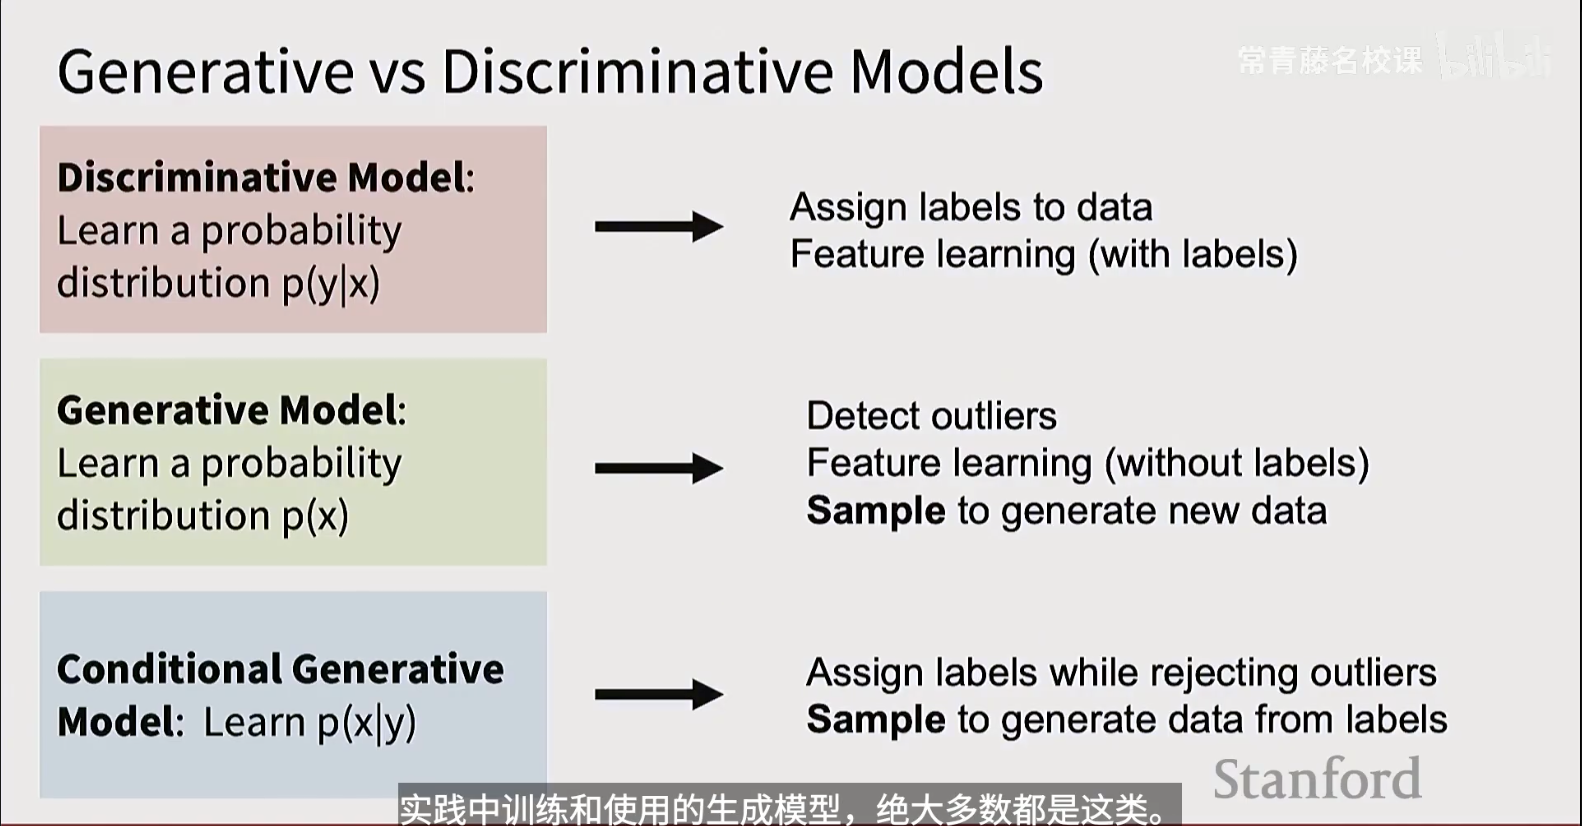
输出具有模糊性
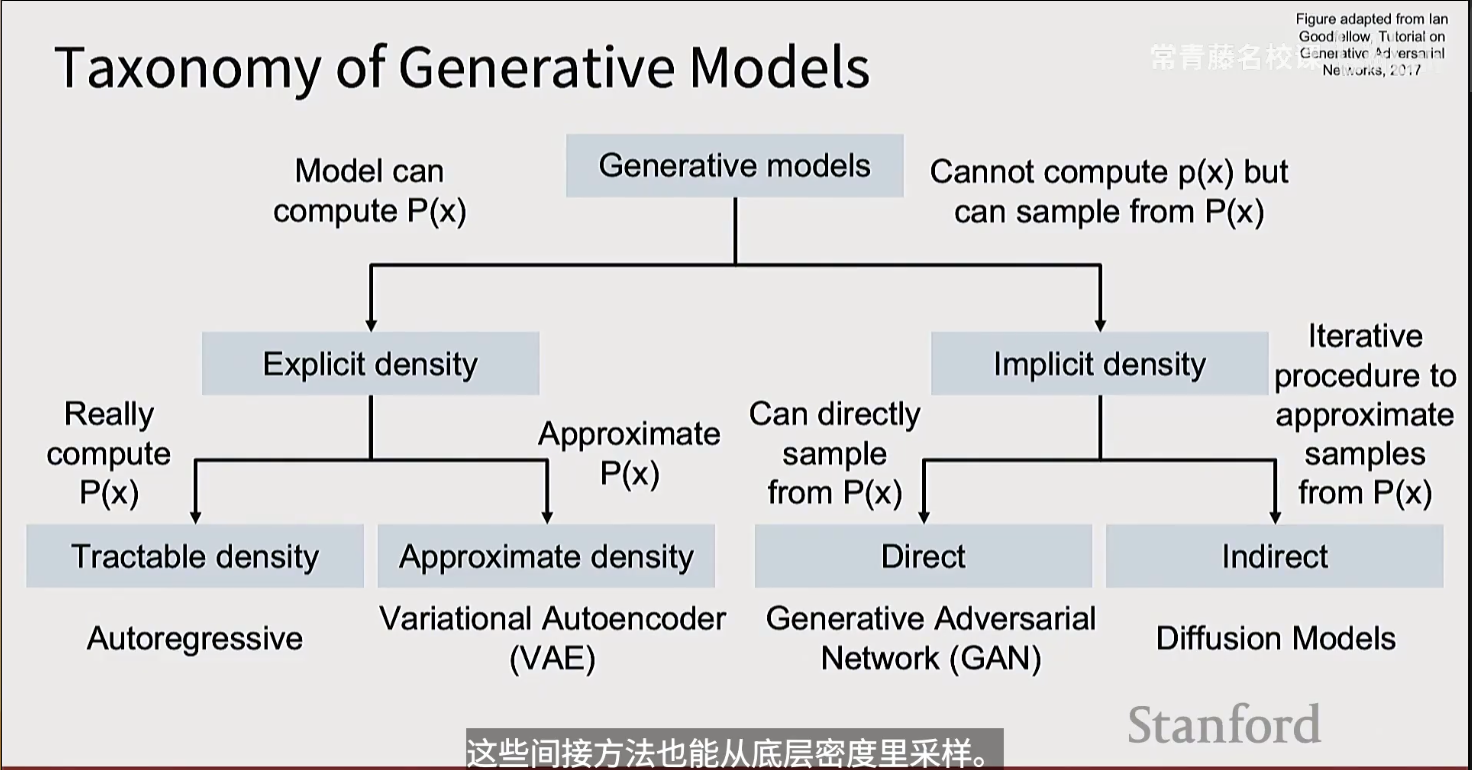
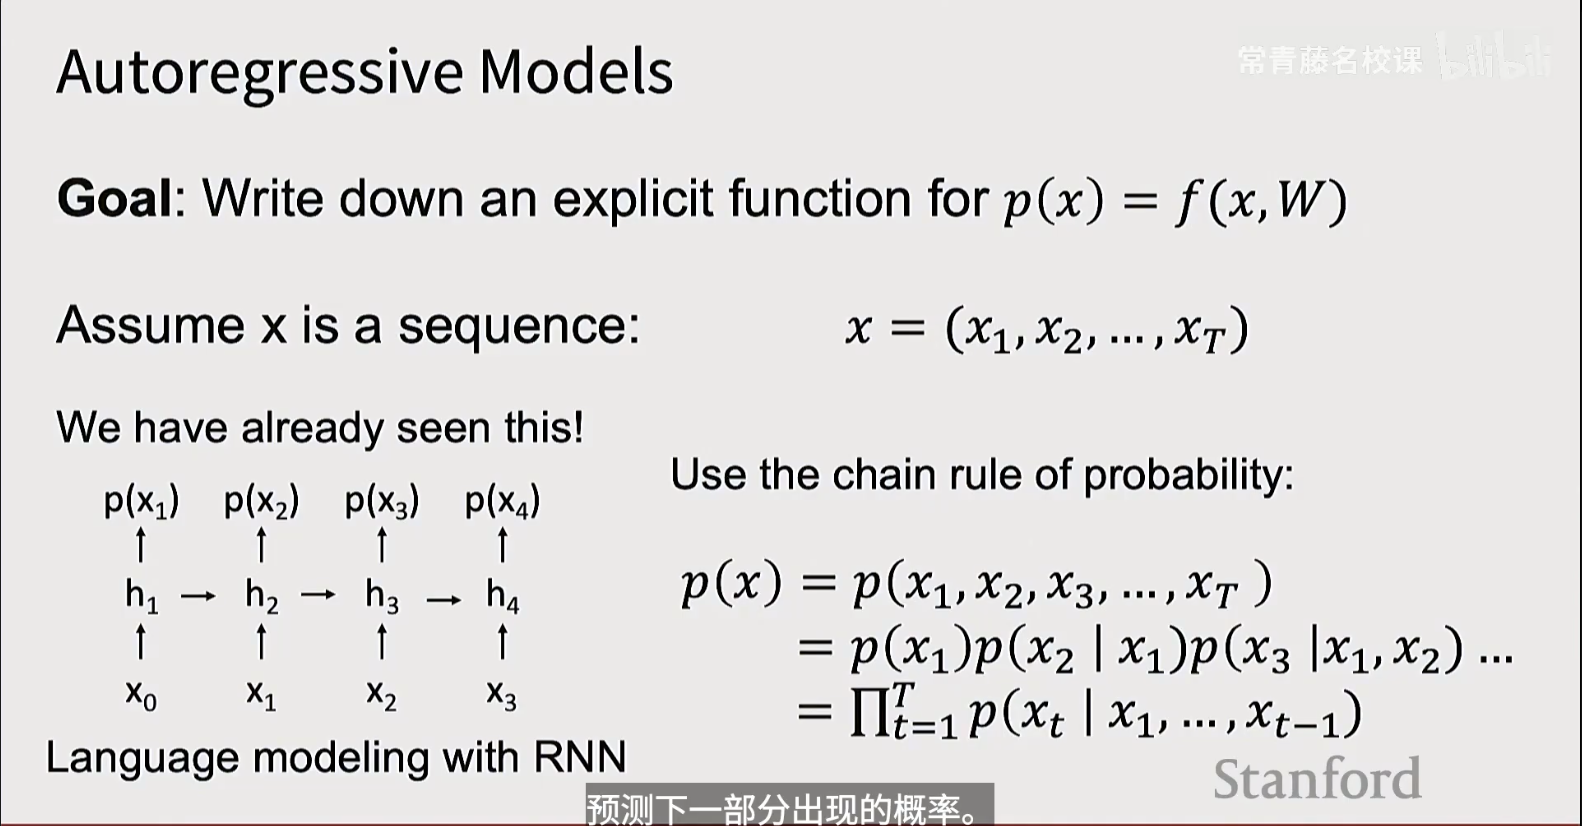
自回归模型
可用 RNN、Transformer
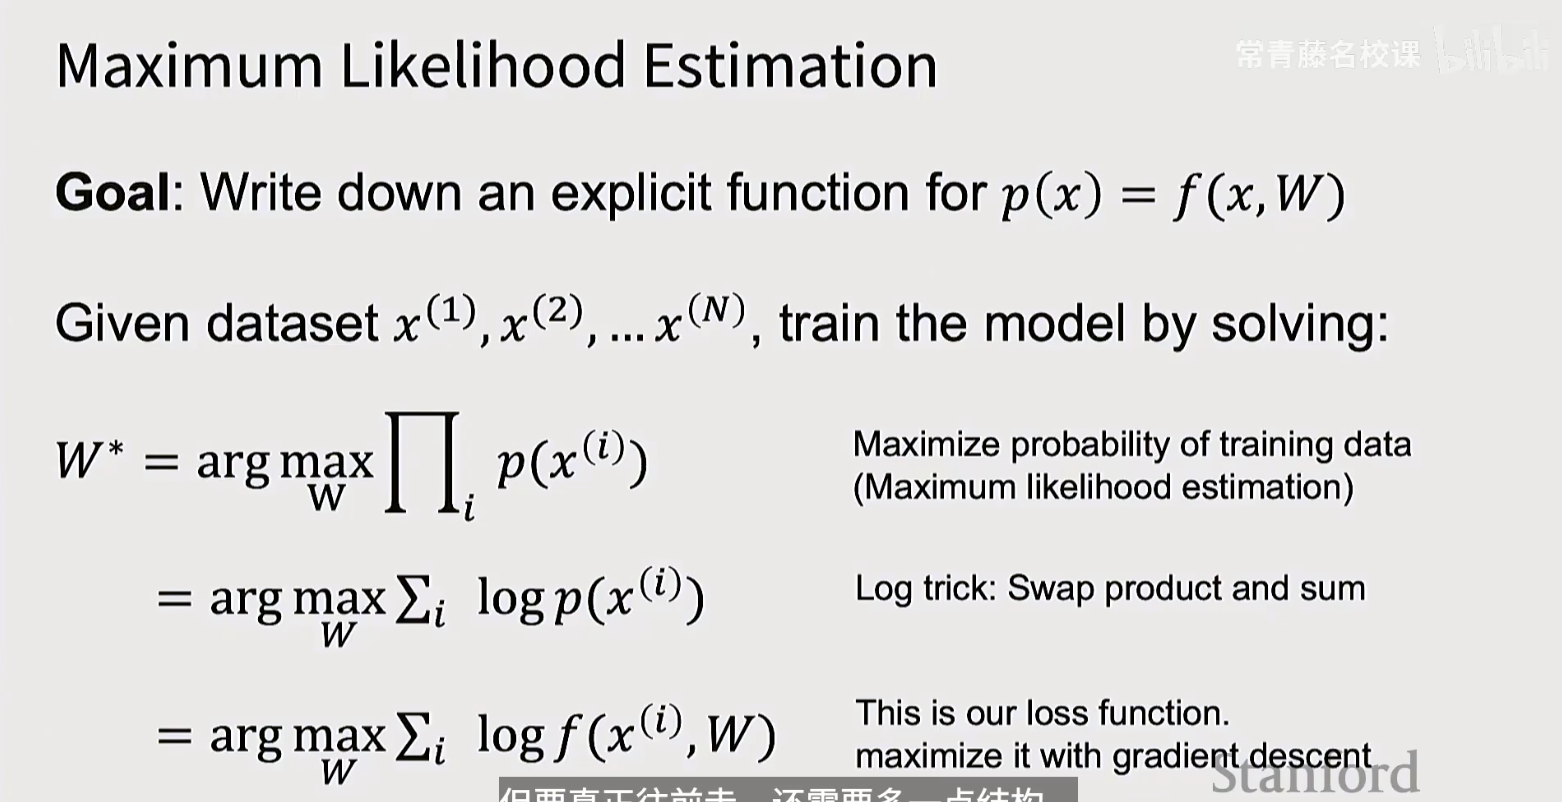
最大似然估计
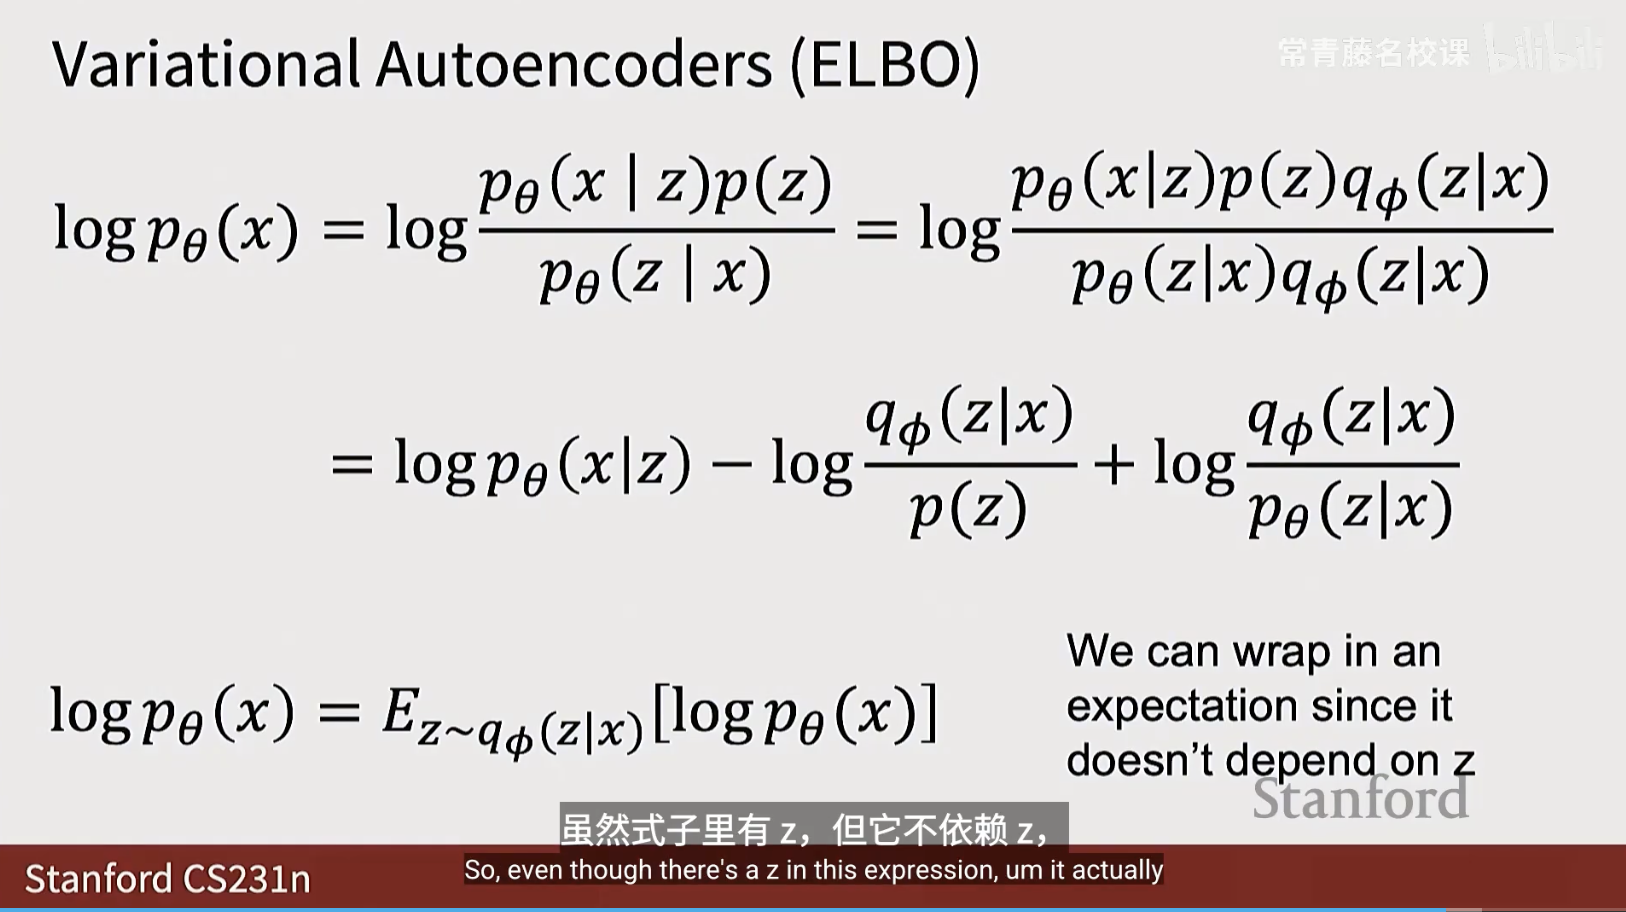
变分自编码器 VAE
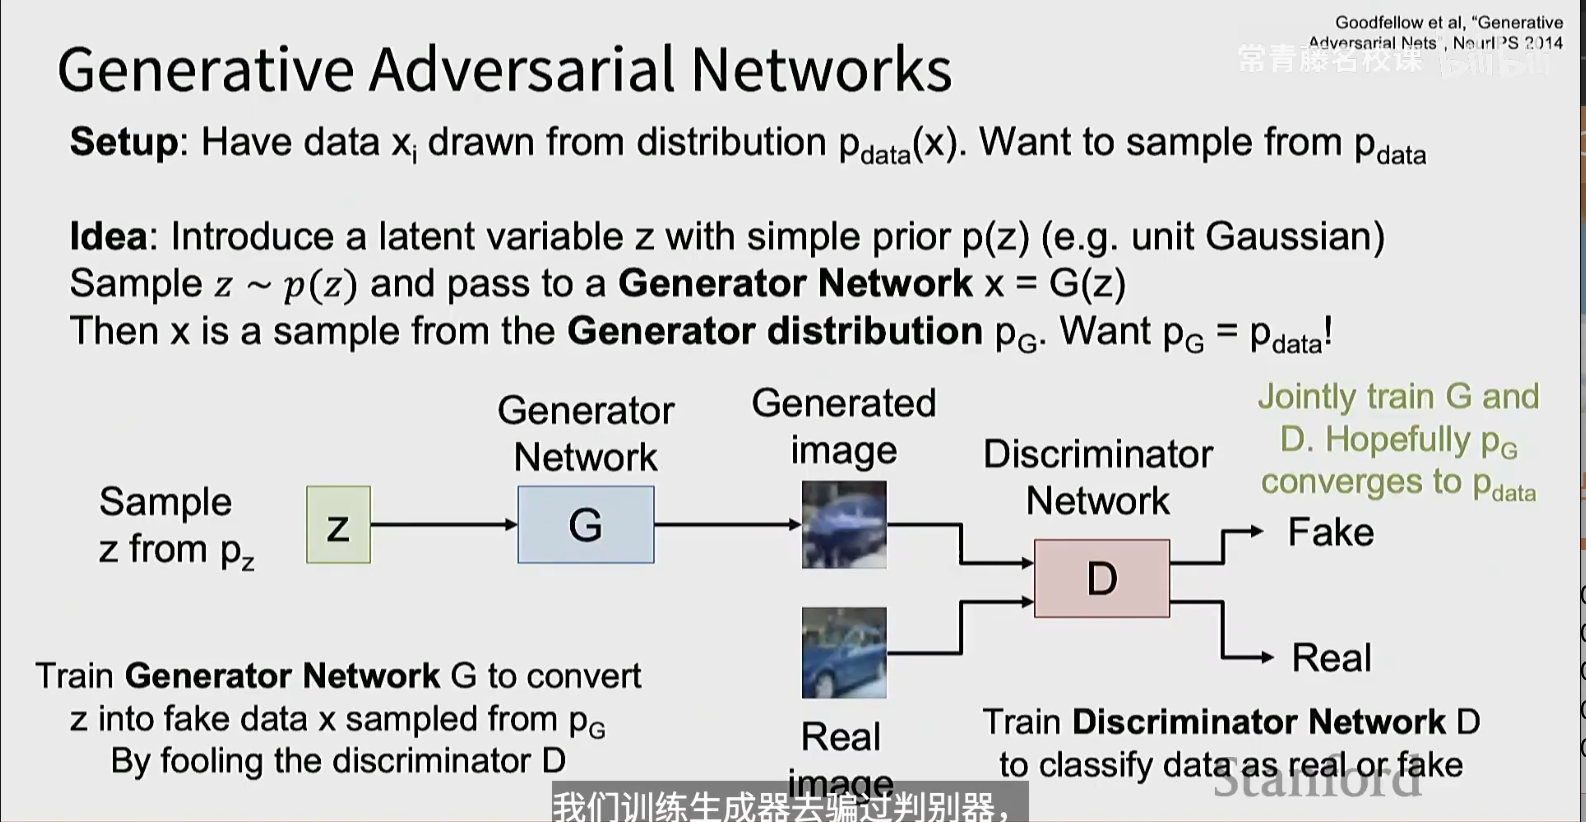
生成对抗网络 GAN
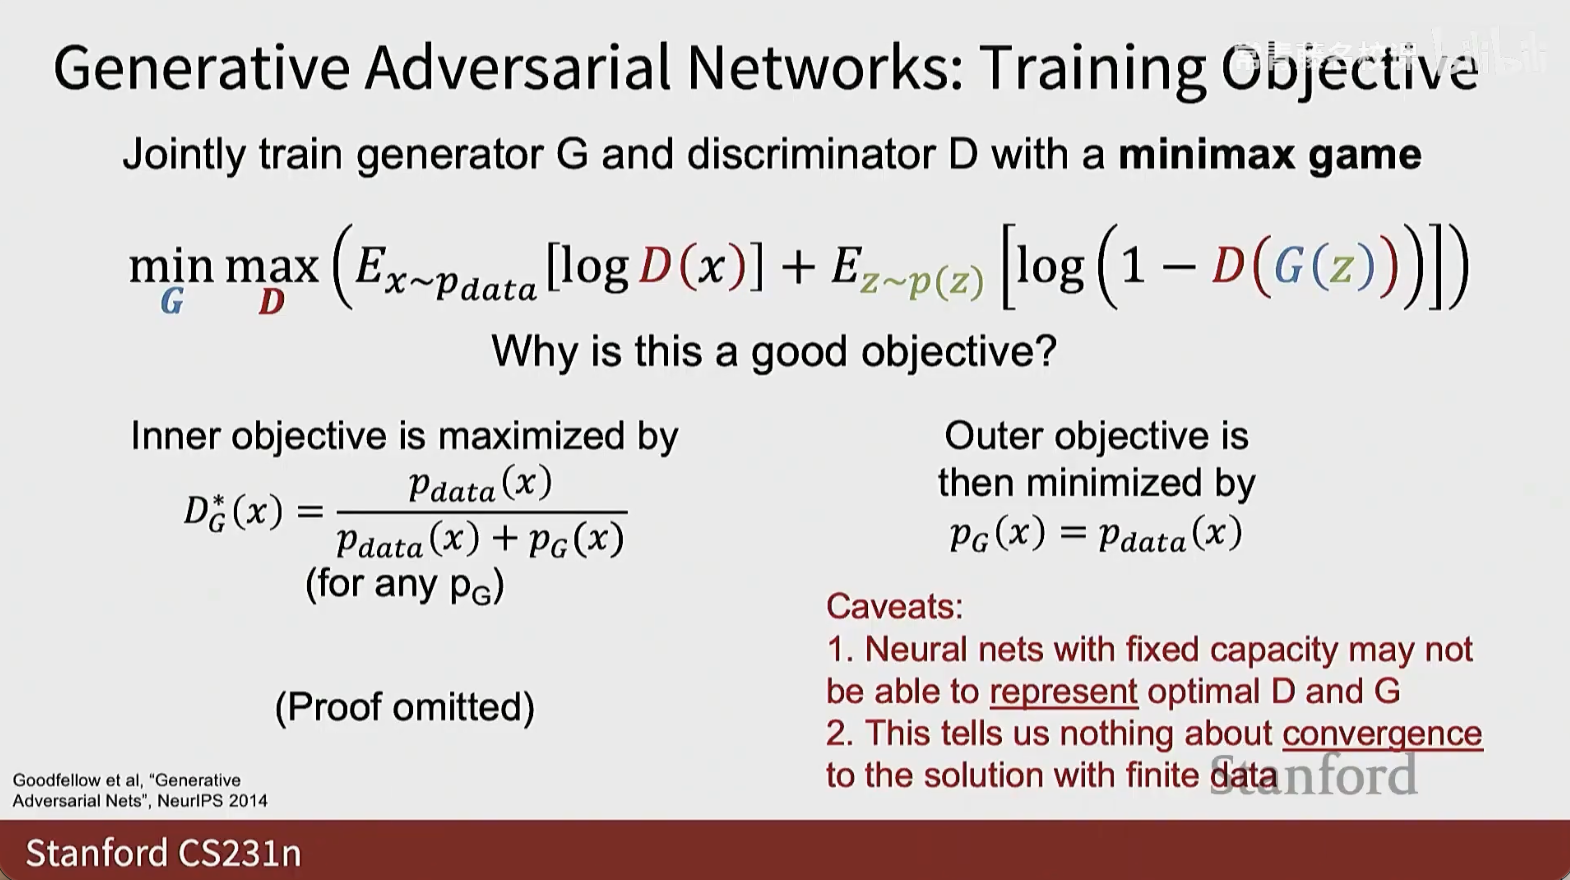
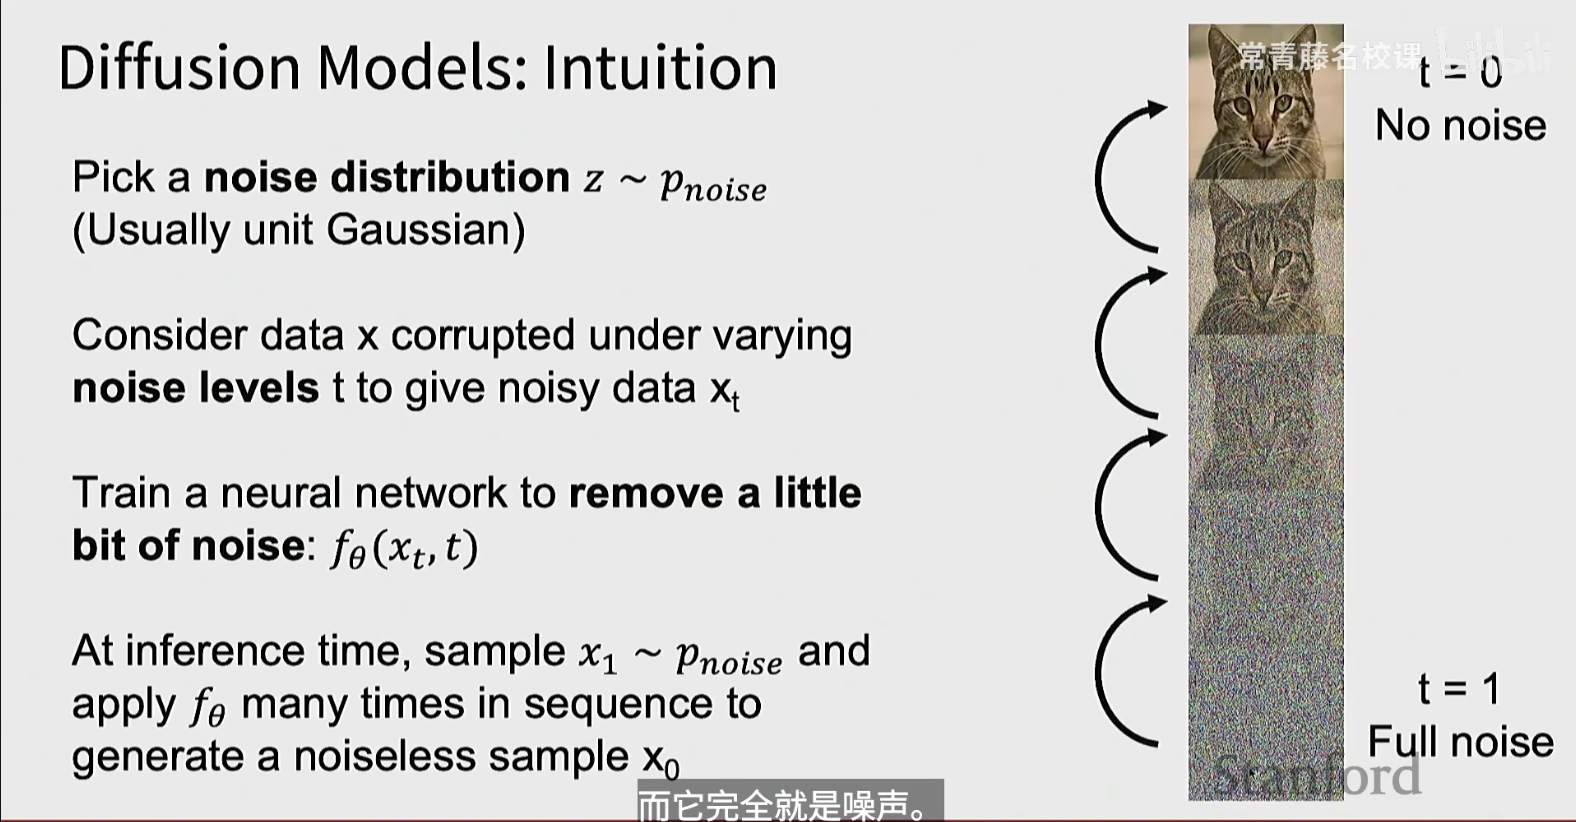
Diffusion Models 扩散模型
关于在机器人中的应用可以看这篇论文
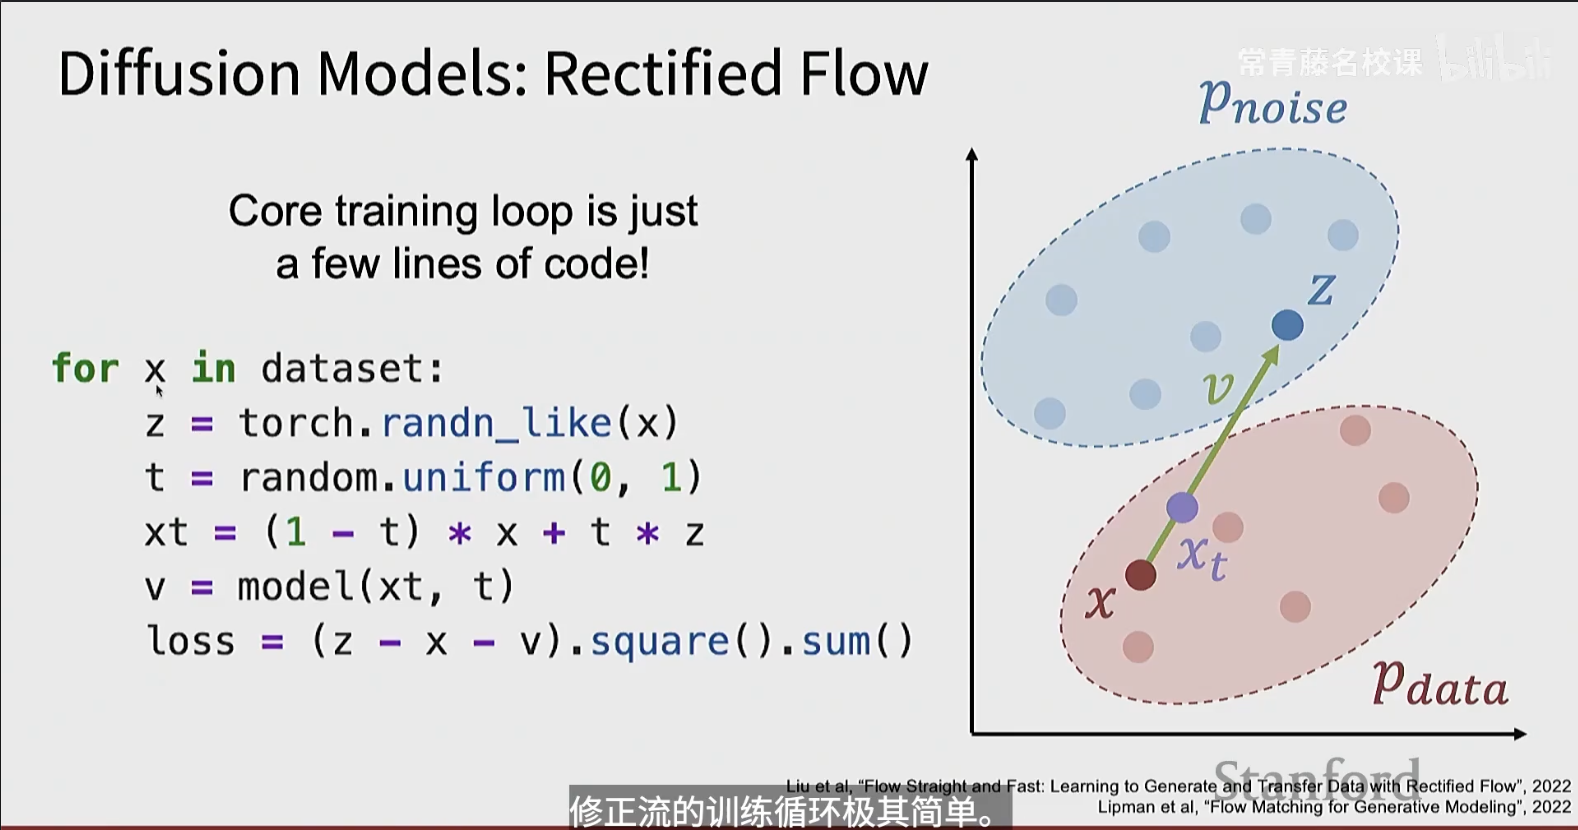
修正流模型 Rectified Flow
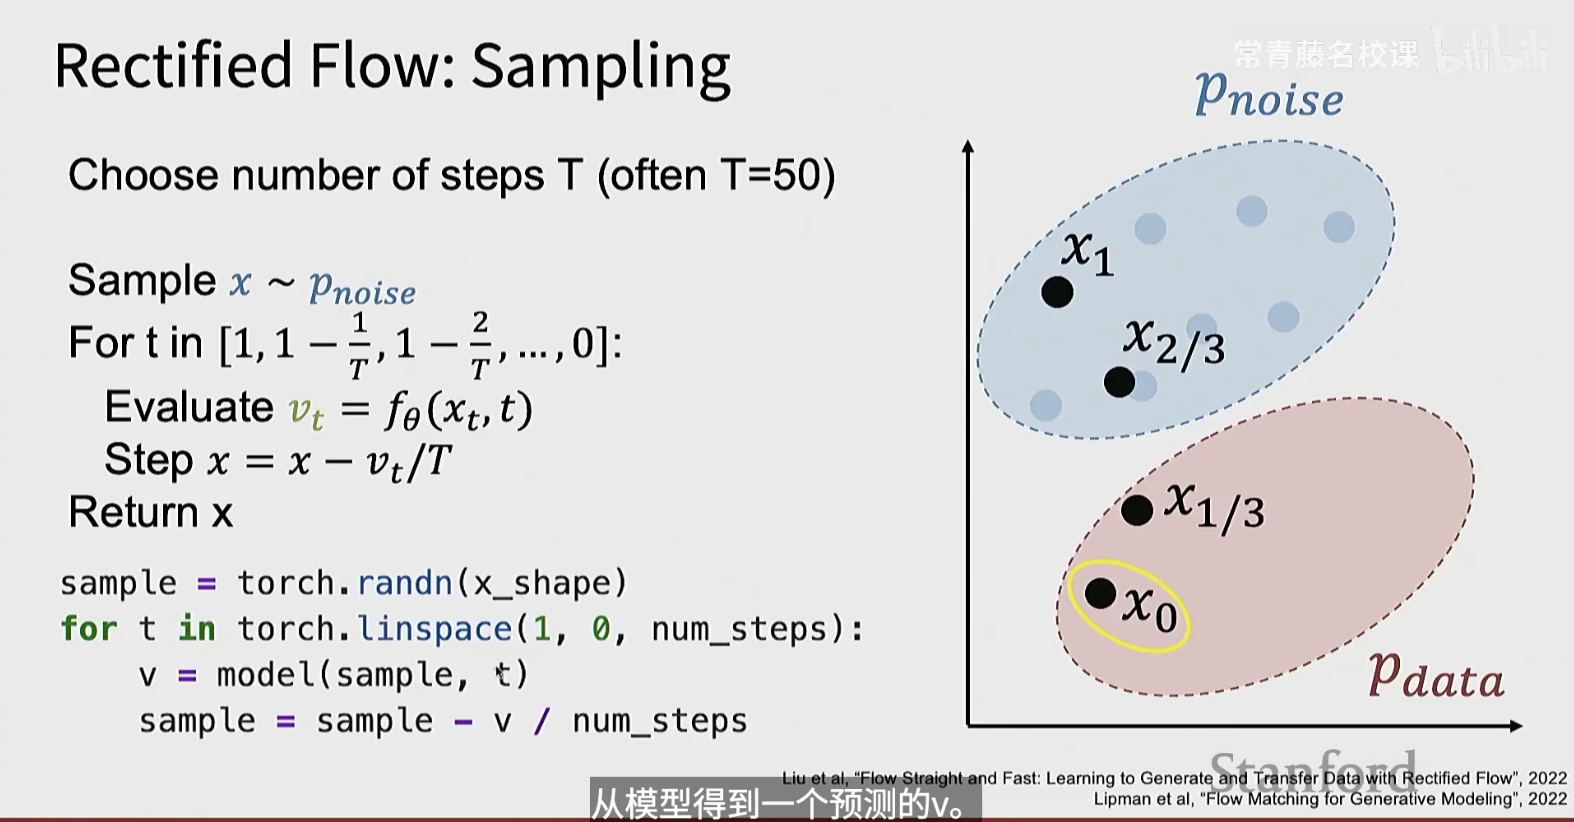
推理过程:
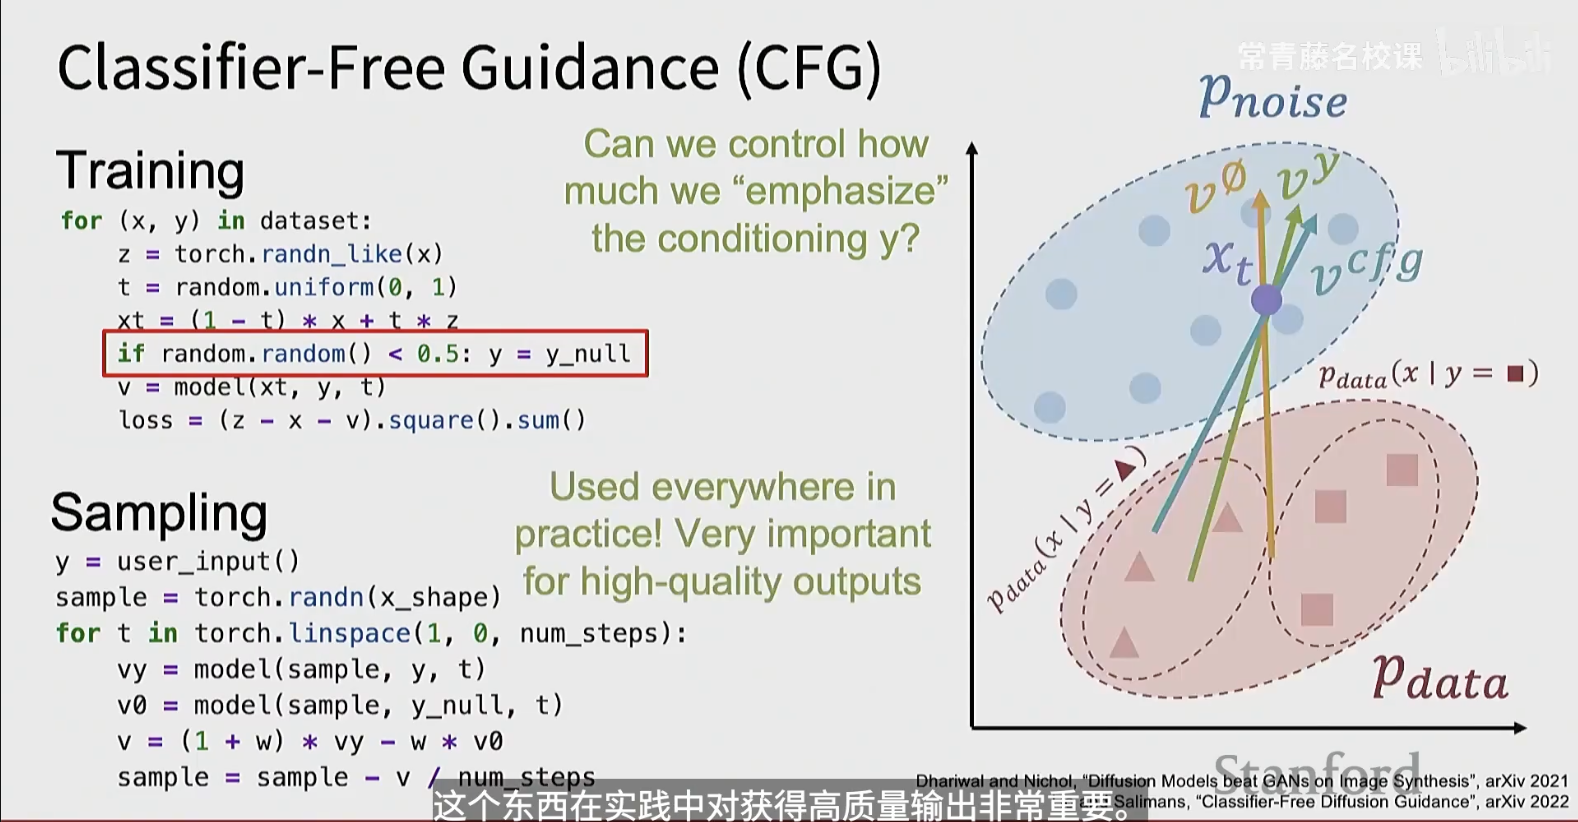
CFG
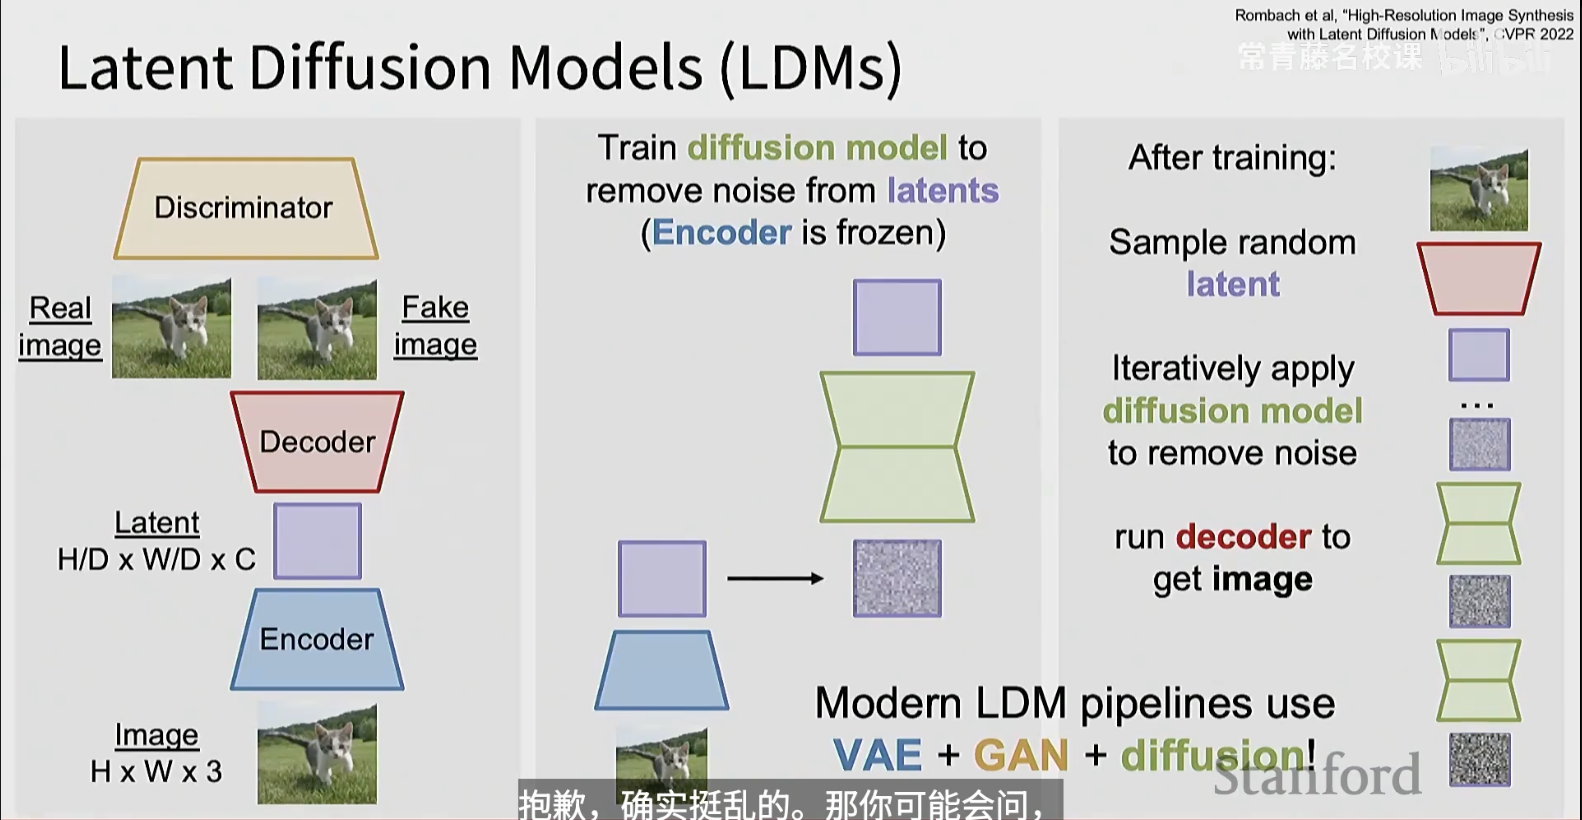
Latent Diffusion Models(LDMs) 潜在扩散模型
Diffusion Transformer
3D Vision
网格
Multi多模态基础模型
SimCLR
CLIP
文本编码器